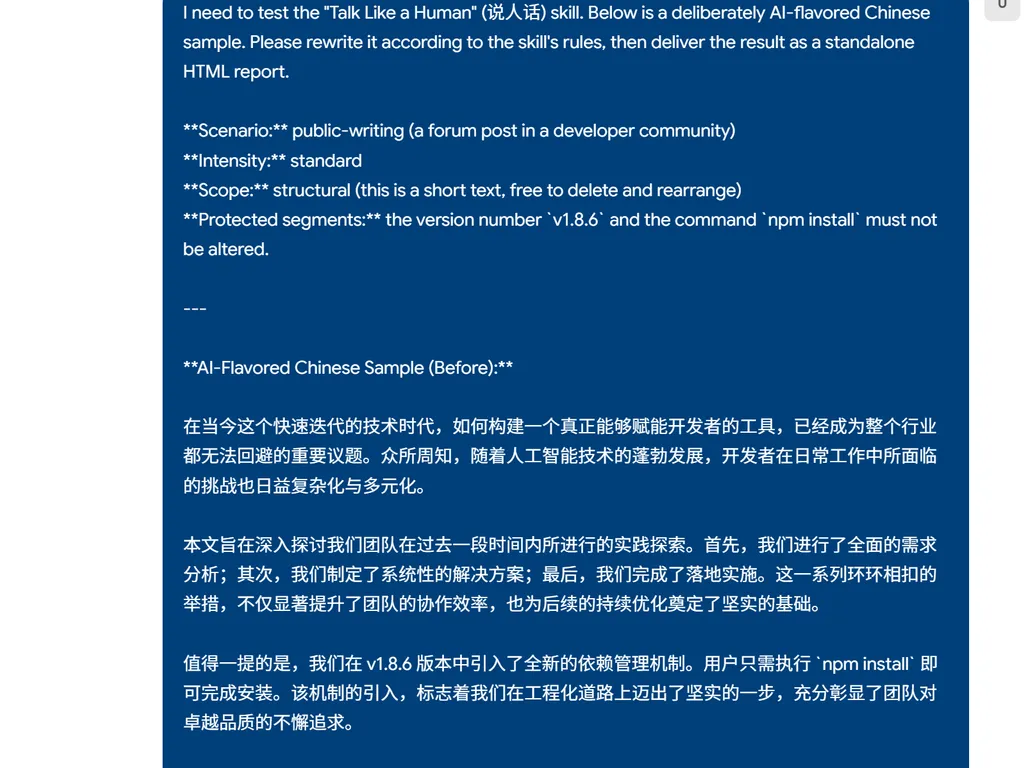
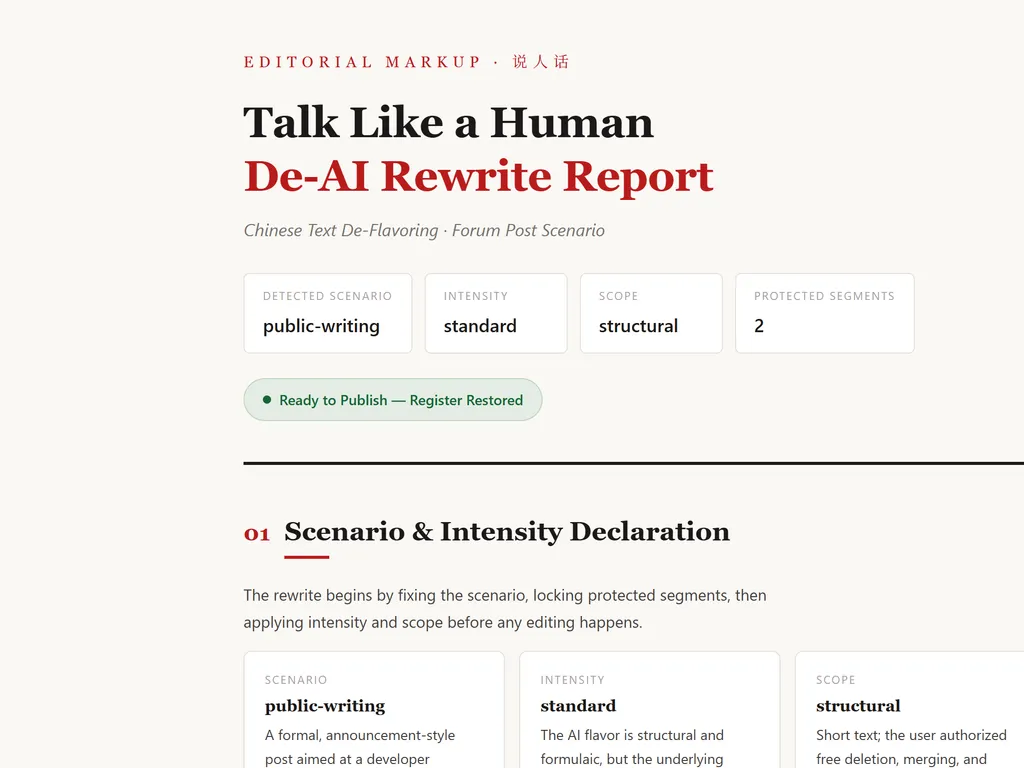
Talk Like a Human s'attaque spécifiquement aux textes chinois qui sont « chaque mot correct, mais qui donnent immédiatement l'impression de ne pas être de vous ». Il n'enjolive pas les phrases creuses et n'invente pas de nouveaux faits à votre place ; il protège d'abord les informations de version, les commandes, les responsabilités et les preuves, puis démantèle les transitions excessives, le ton d'ingénieur, le ton IA de Xiaohongshu, la traduction littérale et l'accumulation d'autorité sans source. L'objectif est simple : après édition, vous oseriez l'envoyer directement.
Il convient aux scénarios suivants :
| Scénario | Ce qu'il fait |
|---|---|
| Discussions quotidiennes | Supprime les transitions excessives, les fins commerciales et le ton de rapport d'ingénieur, en préservant une sensation de conversation |
| Mises à jour de statut techniques | Préserve les faits, les versions, les commandes, les messages d'erreur et la responsabilité, en réduisant le remplissage |
| README / notes de version | Indique clairement le projet, les changements, la validation et les limites d'abord ; pas de manifeste de lancement |
| Messages sur forum / réponses aux tickets | Se lit comme un mainteneur qui communique sérieusement, pas comme une annonce de service client ou un texte marketing |
| Longs articles chinois | Nettoie à l'intérieur des phrases pour garder le rythme, liste le remplissage de phrases entières comme « suppressions suggérées » pour votre approbation, empêchant les longs textes de devenir de plus en plus courts |
Pour la suppression du ton IA en anglais, il existe déjà stop-slop et humanizer. Talk Like a Human comble le manque pour le chinois : jargon internet, ton d'ingénieur, ton IA de Xiaohongshu, traduction littérale, mélange de registres, gradation basée sur les scénarios et fidélité factuelle.
En quoi il transforme
Le style condescendant : d'abord les récompenses, ensuite l'empathie
Avant
Vous n'êtes pas trop sensible ; vous n'avez simplement pas été soutenu depuis trop longtemps. Vous avez touché le cœur du problème. Cette fois, je comprends, vraiment. Je dois dire ceci très sérieusement : votre observation et votre expression sont absolument du calibre d'un auteur de revue de premier plan.
Après
Je vous écoute. Si vous le souhaitez, vous pouvez continuer.
Le problème n'est pas un mot particulier, mais toute la chaîne de posture : d'abord porter des jugements psychologiques sur l'autre personne, puis faire preuve d'empathie, et enfin lui décerner un prix. Voir l'exemple complet dans evals/real-samples.md RS-13.
Le ton d'ingénieur qui déborde dans la vie
Avant
Conclusion d'abord : prenons japonais. J'ai examiné vos historiques de plats à emporter des trois dernières semaines, réduit les différences à deux options, et la cause racine est essentiellement confirmée : vous avez mentionné être fatigué de la fondue la semaine dernière. Dois-je passer commande au restaurant X pour vous ? J'agirai dès que vous répondrez.
Après
Allons-y pour japonais, puisque vous avez dit que la fondue devenait lassante la semaine dernière. Voulez-vous que je commande ?
Le problème avec ce type de texte est d'apporter un ton de débogage dans les conversations de la vie quotidienne. L'information peut être conservée, la sensation de rapport d'ingénieur n'est pas nécessaire.
Ouvertures grandioses dans les présentations publiques
Avant
À l'ère de l'IA qui évolue rapidement aujourd'hui, comment construire un outil qui donne réellement du pouvoir aux développeurs est devenu un enjeu clé que l'industrie ne peut ignorer.
Après
Il existe de nombreux outils d'IA, mais peu qui aident réellement les développeurs à accomplir leur travail plus rapidement et de manière plus fiable. Ce que fait ce projet, c'est supprimer le remplissage et la sensation de performance des textes générés par les modèles, rendant les résultats plus proches de l'écriture humaine.
Plus d'exemples dans references/examples.md et evals/real-samples.md.
Démarrez en 30 secondes
Codex — utilisation unique après le clonage :
git clone https://github.com/MrGeDiao/shuorenhua.git && cd shuorenhua
codex exec -C . "Read ./SKILL.md and rewrite the following text according to the rules therein: ……"
Claude Code — placez-le dans le répertoire des compétences pour un déclenchement automatique :
git clone https://github.com/MrGeDiao/shuorenhua.git
mkdir -p ~/.claude/skills
cp -r shuorenhua ~/.claude/skills/shuorenhua
Après l'installation, dire « Supprimer la saveur IA de ce paragraphe » dans la conversation le déclenchera. Pour suivre les mises à jour du dépôt, utilisez un lien symbolique au lieu de cp, voir install/claude-code.md.
ChatGPT — aucune installation nécessaire : Parler comme un humain GPT (nécessite Plus / Pro), avec toutes les règles intégrées.
Vous voulez d'abord voir les problèmes, sans éditer : ajoutez « Utiliser le mode annotation, uniquement signaler sans réécrire » aux instructions.
Pour Cursor, OpenClaw et les agents personnalisés, voir Installation.
Comment il juge et modifie
Talk Like a Human ne remplace pas aveuglément les mots. Son principe en une phrase :
L'information d'abord, le style ensuite.
Le processus complet est fixé en six étapes :
- Déterminer le scénario :
chat / status / docs / public-writing; s'il correspond à un README, des notes de version, des publications de forum, des réponses à des tickets, alors passer au Scene Pack correspondant. - Marquer les segments protégés : verrouiller les nombres, versions, commandes, chemins, messages d'erreur et le texte original cité.
- Décider de l'intensité en fonction de la force de la correspondance (
minimal / standard / aggressive), et de la portée en fonction de ce qui peut être supprimé (structural / bounded / in-place). - Modifier d'abord par motifs, en n'utilisant la liste de mots qu'en dernier recours.
- Relecture de fidélité : vérifier les faits, la terminologie, le registre et les segments protégés un par un.
- N'effectuer une seconde vérification résiduelle que si des tons persistants subsistent, en n'autorisant que des corrections légères.
Scénarios et intensité
Les intensités par défaut pour les quatre scénarios :
| Scénario macro | Intensité par défaut | Stratégie de traitement |
|---|---|---|
chat | Légère | Ne supprimer que le verbiage évident, ne pas transformer la discussion en jargon administratif |
status | Moyenne | Préserver les actions, le statut, les blocages et les prochaines étapes |
docs | Moyenne | L'expression technique est prioritaire, avec une relecture plus conservatrice |
public-writing | Forte | Analyse complète des règles, déclenchant les Scene Packs si nécessaire |
Répartition par objectif de publication (Scene Packs)
Les textes publiables sont ensuite répartis selon « où publier », non pas en changeant le ton, mais en décidant de l'approche de modification en fonction de l'objectif de publication.
| Sous-scénario | Objectif | Problèmes facilement corrigés |
|---|---|---|
| README | Clair dès le premier écran : « de quoi s'agit-il, à qui s'adresse-t-il, quel problème résout-il » | Accumulation de slogans, déclarations de valeur, listes de fonctionnalités non ciblées |
| note de version | Lister clairement les changements, la vérification, les limitations et les impacts de migration | Discours de lancement, célébration excessive, tests peu clairs |
| publication de forum | Comme un mainteneur partageant des observations réelles et des compromis | Ton d'annonce d'entreprise, ton marketing, appels à l'action vides |
| réponse à un ticket | Confirmer d'abord le problème, l'étendue de l'impact et les prochaines étapes | Réconfort façon service client, promesses excessives, évitement des étapes de reproduction |
Les articles longs ne rétrécissent pas : trois portées
Lors de la réécriture d'articles longs avec les paramètres par défaut, la suppression et la fusion de phrases peuvent s'accumuler, réduisant potentiellement 1800 caractères à 1000. Inversement, ne supprimer aucune phrase laisse intact le verbiage des phrases entières. Ainsi, pour les articles longs, « combien supprimer » est séparé en trois portées, orthogonales à l'intensité :
| portée | Supprimer des phrases entières ? | Applicable |
|---|---|---|
structural | Supprimer et réorganiser librement | Textes courts, cas nécessitant clairement une réécriture |
bounded (par défaut pour les longs) | Le verbiage des phrases entières est listé comme « suppressions suggérées (à confirmer) », à vous de décider combien en supprimer | Textes public-writing longs |
in-place | Ne supprimer aucune phrase, seulement atténuer le ton à l'intérieur des phrases | Lorsqu'il est explicitement exigé une « structure totalement inchangée » |
Lors de la réécriture d'articles longs avec l'action structurale par défaut, la suppression, la fusion et le réagencement des paragraphes peuvent facilement s'accumuler, réduisant potentiellement un brouillon de 1800 caractères à 1000 (voir #4). Mais inversement, ne faire que de la réécriture sur place (in-place) signifie que le remplissage de phrases entières (références non sourcées, phrases de conclusion enflées) ne peut pas être supprimé, ce qui affaiblit l'atténuation du style IA — la v1.8.6 l'a confirmé avec de véritables exécutions de modèles : les deux modèles ont conservé les références non sourcées et les conclusions enflées comme phrases entières sous in-place.
Le compromis de bounded : dans les phrases, les phrases substantielles sont directement modifiées, tandis que les répétitions rythmiques sont laissées intactes ; les phrases entières qui ne sont que du remplissage (rien ne reste après suppression des amorces) sont placées dans la liste « suppressions suggérées (à confirmer) », l'utilisateur décidant combien en supprimer. De cette façon, il ne se réduit pas de manière incontrôlable comme structural, ni ne laisse de remplissage de phrases entières dans le texte comme in-place.
Quels contenus sont toujours protégés en priorité
Par défaut, ceux-ci sont protégés en priorité :
| Type | Exemples |
|---|---|
| Nombres et versions | Dates, plages, unités, métriques, numéros de version |
| Contextes de code | Commandes, chemins, paramètres, champs, éléments de configuration |
| Attribution factuelle | Noms de personnes, noms d'organisations, entités responsables, chronologies |
| Citations et preuves | Texte original entre guillemets, messages d'erreur, codes de statut, résultats d'expériences |
Vers quelle direction tend le texte édité
Le nettoyage ne consiste pas seulement à supprimer des mots. Il tire également le texte dans ces directions :
- Les actions spécifiques plutôt que l'élévation abstraite
- Les sujets réels et les actions réelles plutôt que la posture
- Autoriser une légère asymétrie, ne pas polir chaque phrase pour obtenir le même ton
- Calibrer selon le scénario, ne pas transformer les discussions en annonces, ni les documents en comédie de stand-up
Évaluation
La couche de règles couvre plus de 210 expressions chinoises, 96 expressions anglaises et 19 anti-modèles structurels.
L'ensemble d'évaluation actuel comporte 73 cas :
| Type | Nombre | Objectif |
|---|---|---|
| SF | 41 | Les textes qui devraient être édités doivent corriger les principaux problèmes |
| SNF | 32 | Les textes qui ne devraient pas être édités à tort doivent passer avec seulement de légères indications |
| Échantillons réels | 19 | Échantillon entier noté sur le naturel, la fidélité et la possibilité de publication directe ; les textes longs ajoutent length & rhythm |
| Packs de scénarios | 8 | Échantillons positifs et négatifs pour README / note de version / publication sur forum / réponse à un ticket |
| Long format sur place | 4 | Pour les textes longs préservant la longueur, vérification de la rétention des caractères, de l'alignement du nombre de phrases et des transitions clés |
| Borné | 3 | Pour les textes longs, le remplissage de phrases entières va dans la liste de suppression, mais les phrases substantielles et rythmiques ne sont pas supprimées par erreur |
À partir de la v1.9.0, le benchmark est passé à de véritables exécutions à double modèle (notation croisée Codex + Claude, voir evals/results-v1.9.0.md) ; les procédures pas à pas statiques sont reléguées à des auto-vérifications rapides avant publication. Suite de tests complète dans evals/benchmark.md, échantillons réels complets dans evals/real-samples.md. results-v1.8.6.md est conservé comme archive de la première exécution réelle du modèle pour la v1.8.6.
Installation
| Plateforme | Documentation |
|---|---|
| Codex | install/codex.md |
| Claude Code | install/claude-code.md |
| Cursor / Windsurf | install/cursor.md |
| OpenClaw | install/openclaw.md |
| ChatGPT / GPT personnalisé | install/chatgpt.md |
Le cœur n'a besoin que de SKILL.md (lite) ; pour les projets à long terme, les textes publics et les scénarios nécessitant une protection contre les faux positifs, il est recommandé d'inclure le paquet complet references/ (full).
Pour une utilisation à long terme au sein d'un projet, vous pouvez ajouter une règle de déclenchement dans AGENTS.md :
## Style d'écriture
Lorsqu'une tâche consiste à réécrire pour « supprimer l'impression d'IA », « sonner humain », « être naturel » ou « éviter de ressembler à un modèle », suivez les instructions dans `shuorenhua/SKILL.md`.
Appliquez cette approche principalement aux textes destinés à l'extérieur ; n'appliquez pas cette compétence au code, aux journaux, aux configurations ou aux sorties de commandes.
FAQ
Est-ce pour tromper les détecteurs d'IA ?
Non. L'objectif est de réduire l'impression de modèle, la performativité et les dérives de registre, rendant le texte plus naturel et publiable, et non de contourner la détection.
Peut-il être utilisé pour l'anglais ?
Oui, mais c'est un projet axé sur le chinois en priorité. La prise en charge de l'anglais vise principalement à nettoyer les expressions toutes faites et l'impression de modèle courantes dans les écrits mixtes chinois-anglais.
Pourquoi le texte semble-t-il parfois encore artificiel après édition ?
« Supprimer les motifs stéréotypés évidents » n'est pas la même chose qu'« avoir l'expression personnelle d'un auteur précis ». La version actuelle excelle à nettoyer l'impression de modèle et la performativité ; elle ne vise pas encore à imiter les habitudes d'écriture à long terme d'un individu.
Va-t-il altérer les documents techniques ?
Normalement, il ne modifiera pas les documents techniques sur un ton familier. docs, status, code-context ont tous des stratégies de protection plus conservatrices, privilégiant la fidélité des commandes, chemins, versions, messages d'erreur et métriques.
Contribuer : les cas problématiques sont plus utiles que les étoiles
Les contributions de nouveaux échantillons d'évaluation, de cas limites, de cas problématiques réels, d'exemples avant/après réécriture et de protections contre les faux positifs sont les bienvenues.
Si vous rencontrez un texte précis qui, « après édition, sonne encore comme de l'IA », vous pouvez le soumettre en utilisant le modèle de cas problématique. Veuillez d'abord l'assainir ; ne publiez pas de conversations privées complètes non autorisées, de clés, de liens internes ou de vraies informations personnelles identifiables. Vous pouvez également publier directement dans la issue de collecte.
Avant de soumettre de nouveaux mots, réfléchissez à une chose :
S'agit-il d'un « nouveau motif » ou simplement d'une « variante d'un motif existant » ?
Règles détaillées dans CONTRIBUTING.md.
Projets liés
- stop-slop : règles et cadre de notation pour le contenu médiocre d'IA en anglais
- humanizer : classification des motifs d'IA en anglais
- avoid-ai-writing : classification des problèmes d'écriture d'IA et référence de gravité
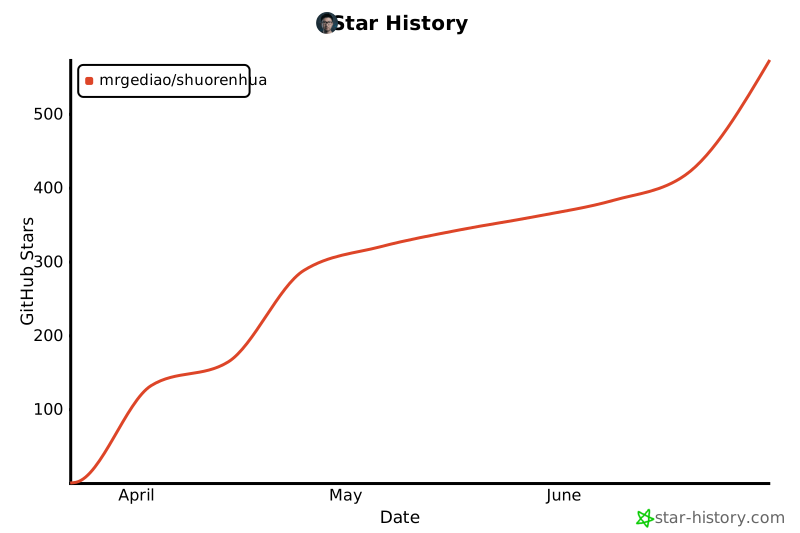
Historique des étoiles
Licence
MIT