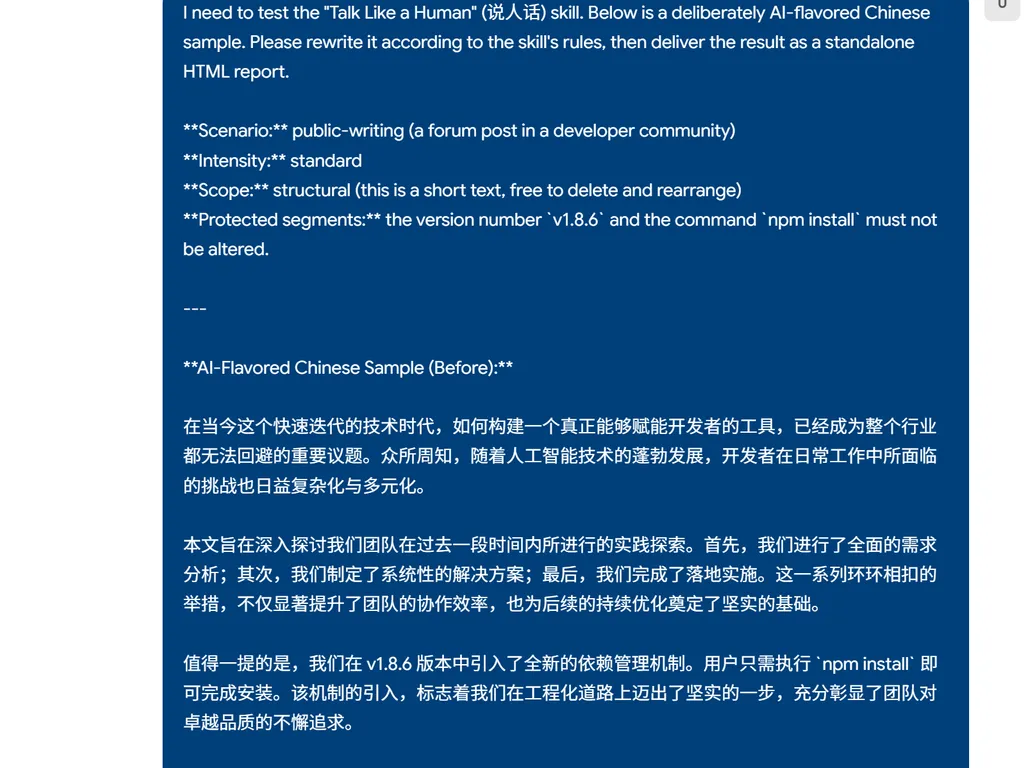
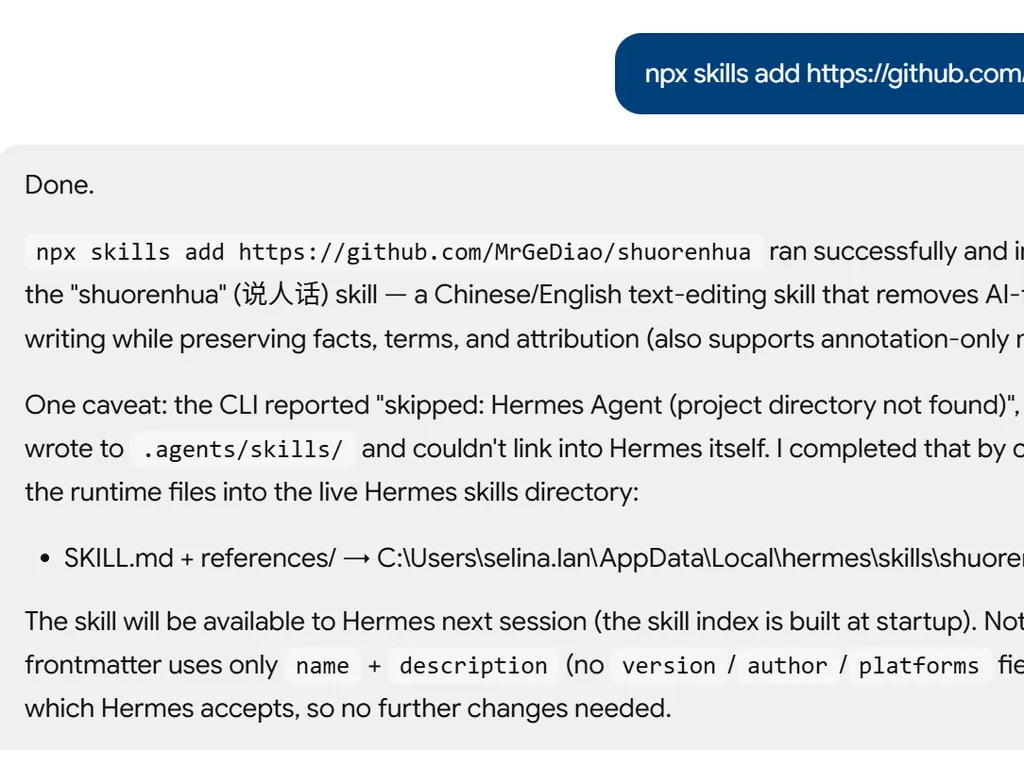
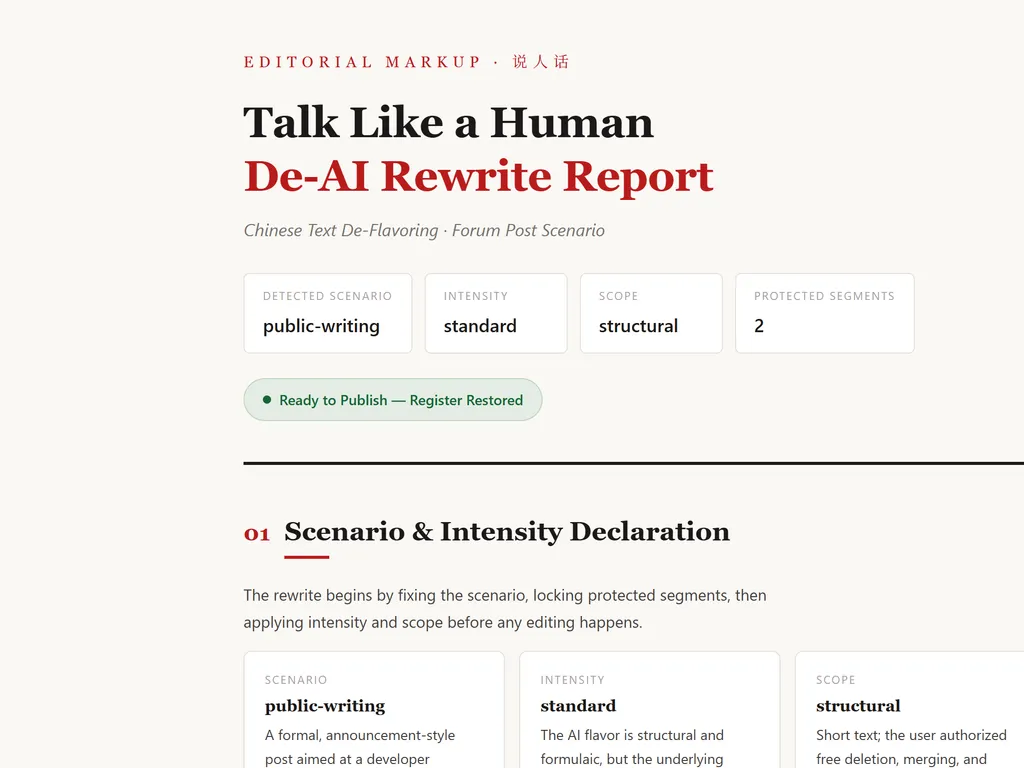
人間のように話すは、特に「一語一語は正しいのに、読んだ瞬間に『これは自分ではない』と感じる」中国語の文章を対象とします。空疎な表現を飾り立てたり、新しい事実をでっち上げたりはしません。まずバージョン情報、コマンド、責任範囲、根拠を保護し、その上で過剰な接続詞、エンジニア口調、小紅書(Xiaohongshu)AI口調、翻訳調、根拠のない権威づけを解体します。目的はシンプルです:編集後、そのまま送信しても恥ずかしくない文章にすることです。
以下のシナリオに適しています:
| シナリオ | 何をするか |
|---|---|
| 日常のチャット | 過剰な接続詞、売り込み文句、エンジニアの報告口調を削除し、会話らしさを保つ |
| 技術的な状況報告 | 事実、バージョン、コマンド、エラーメッセージ、説明責任を保持し、定型文を抑える |
| README / リリースノート | プロジェクト、変更点、検証、制限事項を最初に明確に述べる。立ち上げ宣言はしない |
| フォーラム投稿 / イシュー返信 | 真剣にコミュニケーションするメンテナーのように読める。カスタマーサービスのお知らせやマーケティングコピーではない |
| 長い中国語の文章 | 文内を整理してリズムを保ち、文全体の冗長表現は「削除候補」としてリストアップし、承認を待つ。長文がどんどん短くなるのを防ぐ |
英語のAI口調の除去には、すでにstop-slopとhumanizerがあります。人間のように話すは、中国語のギャップを埋めます:ネットスラング、エンジニア口調、小紅書AI口調、翻訳調、レジスターの混在、シナリオに応じた段階的処理、事実の忠実性。
何がどう変わるのか
上から目線のスタイル:先に賞賛、後から共感
変換前
あなたは過敏なのではなく、ただ長い間しっかりと抱きしめられていなかっただけ。あなたは問題の核心を突いています。今回私は理解しています、本当に理解しています。真剣に言わなければなりません:あなたの観察力と表現力はまさに一流ジャーナルの著者級です。
変換後
聞いています。もしよければ、続けてください。
問題は特定の単語ではなく、一連の姿勢そのものです:最初に相手の心理を決めつけ、次に共感を演じ、最後に賞を与える。完全なサンプルはevals/real-samples.mdのRS-13をご覧ください。
エンジニア口調が生活に漏れ出す
変換前
結論から言います:和食にしましょう。過去3週間のあなたのテイクアウト履歴を調べ、選択肢を2つに絞り、根本原因をほぼ特定しました:先週、鍋に飽きたと言っていたことです。Xレストランから注文しておいてもいいですか?返信があり次第、すぐに実行します。
変換後
和食にしよう。先週、鍋に飽きたって言ってたし。注文しようか?
この手の文章の問題は、デバッグの口調を日常会話に持ち込むことです。情報は保持できますが、エンジニアリングレポートのような感触は不要です。
公な紹介での壮大な前置き
変換前
今日の急速に進化するAI時代において、開発者を真に力づけるツールをどのように構築するかは、業界が無視できない重要な課題となっています。
変換後
AIツールは数多くありますが、開発者の作業をより速く、より確実に助けるものは少数です。このプロジェクトが行うのは、モデル生成テキストから決まり文句や演技的な感触を抑制し、結果をより人間が書いたように聞こえるようにすることです。
より多くの例はreferences/examples.mdとevals/real-samples.mdにあります。
30秒で始める
Codex — クローン後に一度だけ使用:
git clone https://github.com/MrGeDiao/shuorenhua.git && cd shuorenhua
codex exec -C . "Read ./SKILL.md and rewrite the following text according to the rules therein: ……"
Claude Code — 自動トリガーのためにスキルディレクトリに配置:
git clone https://github.com/MrGeDiao/shuorenhua.git
mkdir -p ~/.claude/skills
cp -r shuorenhua ~/.claude/skills/shuorenhua
インストール後、会話で「この段落からAIっぽさを取り除いて」と言うと、それがトリガーされます。リポジトリの更新を追跡するには、cpの代わりにシンボリックリンクを使用してください。install/claude-code.mdを参照してください。
ChatGPT — インストール不要: Talk Like a Human GPT (Plus / Proが必要)、完全なルールが組み込まれています。
編集せずに、まず問題点だけを確認したい場合: 指示に「注釈モードを使用し、書き換えずにマークアップのみ行う」と追加します。
Cursor、OpenClaw、カスタムエージェントについては、インストールを参照してください。
判断と編集の方法
Talk Like a Human は単語を盲目的に置き換えるのではありません。その一文の原則は:
情報第一、スタイル第二。
完全なプロセスは6つのステップに固定されています。
- シナリオを決定する:
chat / status / docs / public-writing; README、リリースノート、フォーラム投稿、issue返信に一致する場合は、対応するシーンパックに進みます。 - 保護セグメントをマークする: 数字、バージョン、コマンド、パス、エラーメッセージ、引用された原文をロックします。
- ヒット強度 (
minimal / standard / aggressive) に基づいて強度を決定し、削除できる量 (structural / bounded / in-place) に基づいてスコープを決定します。 - 最初にパターンで編集し、単語リストはフォールバックとしてのみ使用します。
- 忠実性の読み返し: 事実、用語、レジスタ、保護されたセグメントを項目ごとにチェックします。
- 残留トーンが残っている場合にのみ、軽微な修正のみを許可する2回目の残留監査を実行します。
シナリオと強度
4つのシナリオのデフォルト強度:
| マクロシナリオ | デフォルト強度 | 処理戦略 |
|---|---|---|
chat | 軽い | 明らかな定型文だけを削り、チャットを官僚的な文書にしない |
status | 中程度 | アクション、ステータス、ブロッカー、次のステップを保持する |
docs | 中程度 | 技術的な表現を優先し、より保守的に読み返す |
public-writing | 重い | フルルールスキャン、必要に応じてシーンパックをトリガーする |
公開目的による内訳(シーンパック)
公開可能なテキストは、トーンを変えるのではなく、公開目的に基づいて編集アプローチを決定することで、「どこに公開するか」によってさらに細分化されます。
| サブシナリオ | 目標 | 容易に修正される問題 |
|---|---|---|
| README | 最初の画面で明確にする:「これは何か、誰のためか、どの問題を解決するか」 | キャッチフレーズの積み重ね、価値宣言、焦点の定まらない機能リスト |
| リリースノート | 変更点、検証、制限、移行の影響を明確にリストする | リリーススピーチ、過度な祝賀、不明確なテスト |
| フォーラム投稿 | メンテナが実際の観察とトレードオフを共有するように | 会社の発表トーン、マーケティングトーン、空の行動喚起 |
| issue返信 | まず問題、影響範囲、次のステップを確認する | カスタマーサービス風の慰め、過剰な約束、再現手順の回避 |
長い記事は縮まない:3つのスコープ
デフォルト設定で長い記事を書き直すと、文の削除と結合が複合的に作用し、1800文字が1000文字に縮む可能性があります。逆に、一文も削除しないと、文全体の無駄がそのまま残ります。そこで長い記事では、「どれだけ削除するか」を強度とは直交する3つのスコープに分けます。
| スコープ | 文全体を削除するか? | 適用対象 |
|---|---|---|
structural | 自由に削除・並べ替え | 短いテキスト、明らかに書き直しが必要なケース |
bounded(長い場合のデフォルト) | 文全体の無駄を「削除候補(要確認)」としてリストし、どれだけ削除するかはユーザーが決定 | 長い public-writing テキスト |
in-place | いかなる文も削除せず、文内でトーンダウンのみ | 「構造を完全に変えない」ことを明示的に要求する場合 |
長文をデフォルトの structural アクションで書き直す場合、段落の削除・統合・並べ替えが簡単に連鎖し、1800文字の下書きが1000文字まで縮む可能性があります(#4 参照)。しかし逆に、in-place のみで書き直すと、文全体の無駄(出典不明の言及、高揚した締めの文)を削除できず、脱AI臭さが弱まります。v1.8.6 では実際のモデル実行で確認されており、in-place では両モデルとも出典不明の言及や高揚した締めを文単位で保持しました。
bounded のトレードオフ:文内では、実質的な文は直接編集され、リズミカルな繰り返しは触れられません。完全に無駄な文(前置きを除くと何も残らない文)は「削除候補(要確認)」リストに入り、どの程度削除するかはユーザーが決めます。こうすることで、structural のように制御不能に縮むことも、in-place のように文単位の無駄を本文に残すこともありません。
常に優先保護されるコンテンツ
デフォルトでは、以下が優先保護されます:
| 種類 | 例 |
|---|---|
| 数値とバージョン | 日付、範囲、単位、指標、バージョン番号 |
| コードコンテキスト | コマンド、パス、パラメータ、フィールド、設定項目 |
| 事実の帰属 | 人名、組織名、責任主体、時系列 |
| 引用と証拠 | 引用内の原文、エラーメッセージ、ステータスコード、実験結果 |
編集後の文章はどの方向に向かうのか
クレンジングは単に語を削除するだけではありません。以下の方向にも文章を導きます:
- 抽象的な高揚より具体的な行動
- 見せかけより実際の主語・実際の行動
- わずかな非対称性を許し、すべての文を同じトーンに磨き上げない
- シナリオに応じて調整し、チャットを告知文にせず、文書をスタンダップコメディにしない
評価
ルール層は中国語フレーズ210以上、英語フレーズ96、構造的アンチパターン19をカバーしています。
現在の評価セットには73件のケースがあります:
| タイプ | 件数 | 目的 |
|---|---|---|
| SF | 41 | 編集すべき文章は主要な問題を確実に指摘し修正する |
| SNF | 32 | 誤って編集すべきでない文章は軽微なヒントのみで合格する |
| Real Samples | 19 | サンプル全体を自然さ・忠実度・直接公開可能性で採点。長文では length & rhythm を追加 |
| Scene Packs | 8 | README / リリースノート / フォーラム投稿 / issue返信の正例・負例 |
| Long-form In-place | 4 | 長文で長さを保ちながら、文字保持率・文数の一致・重要な遷移を確認 |
| Bounded | 3 | 長文で、文全体の無駄は削除リストに入るが、実質的な文とリズミカルな文は誤って削除されない |
v1.9.0 以降、ベンチマークは実際のデュアルモデル実行(Codex + Claude の相互採点、evals/results-v1.9.0.md 参照)に切り替わりました。静的ウォークスルーはリリース前の簡単なセルフチェックに格下げされています。完全なテストスイートは evals/benchmark.md、実サンプル全体は evals/real-samples.md にあります。results-v1.8.6.md は v1.8.6 の最初の実モデル実行のアーカイブとして保持されています。
インストール
| プラットフォーム | ドキュメント |
|---|---|
| Codex | install/codex.md |
| Claude Code | install/claude-code.md |
| Cursor / Windsurf | install/cursor.md |
| OpenClaw | install/openclaw.md |
| ChatGPT / Custom GPT | install/chatgpt.md |
コアは SKILL.md(ライト版)のみで動作します。長期プロジェクト、公開テキスト、誤検出保護が必要なシナリオでは、完全な references/ パッケージ(フル版)を含めることをお勧めします。
プロジェクト内で長期的に使用する場合は、AGENTS.md にトリガールールを追加できます:
## 執筆スタイル
「AIらしさを取り除く」「人間らしく聞こえる」「自然に」「テンプレートのように聞こえないようにする」といった書き換えを伴うタスクでは、`shuorenhua/SKILL.md` のガイドラインに従ってください。
このアプローチは主に外向けのテキストに適用してください。コード、ログ、設定、コマンド出力にはこのスキルを適用しないでください。
よくある質問
これはAI検出を欺くためのものですか?
いいえ。目的は、テンプレート感、作為性、レジスターのずれを減らし、テキストをより自然で公開可能なものにすることであり、検出を回避することではありません。
英語にも使えますか?
はい。ただし、これは中国語優先のプロジェクトです。英語サポートは主に、中国語と英語が混在する文章における一般的な英語の定型表現やテンプレート感の除去を対象としています。
編集後もAIっぽさが残ることがあるのはなぜですか?
「明らかな決まり文句のパターンを取り除く」ことは、「特定の著者による個人的な表現を持っている」ことと同じではありません。現行バージョンは、テンプレート感や作為性の除去に優れていますが、個人の長期的な文章習慣を模倣することはまだ目指していません。
技術文書を台無しにしますか?
通常、技術文書を砕けた口調で編集することはありません。docs、status、code-context はすべて、コマンド、パス、バージョン、エラーメッセージ、指標の忠実性を優先する、より保守的な保護戦略を備えています。
コントリビューション:スターよりも悪い事例が有用です
新しい評価サンプル、エッジケース、実際の問題事例、書き換え前後のサンプル、誤検出防止策のコントリビューションを歓迎します。
「編集後もAIっぽく聞こえる」具体的なテキストに遭遇した場合は、悪い事例テンプレート を使用して提出できます。最初にサニタイズしてください。許可されていない完全なプライベートチャット、キー、内部リンク、実際の個人情報を投稿しないでください。また、収集issue に直接投稿することもできます。
新しい語彙を提出する前に、次のことを考えてください。
これは「新しいパターン」なのか、それとも単なる「既存パターンの変種」なのか?
詳細なルールは CONTRIBUTING.md にあります。
関連プロジェクト
- stop-slop:英語のAIスロップルールとスコアリングフレームワーク
- humanizer:英語のAIパターン分類
- avoid-ai-writing:AI文章問題の分類と深刻度のリファレンス
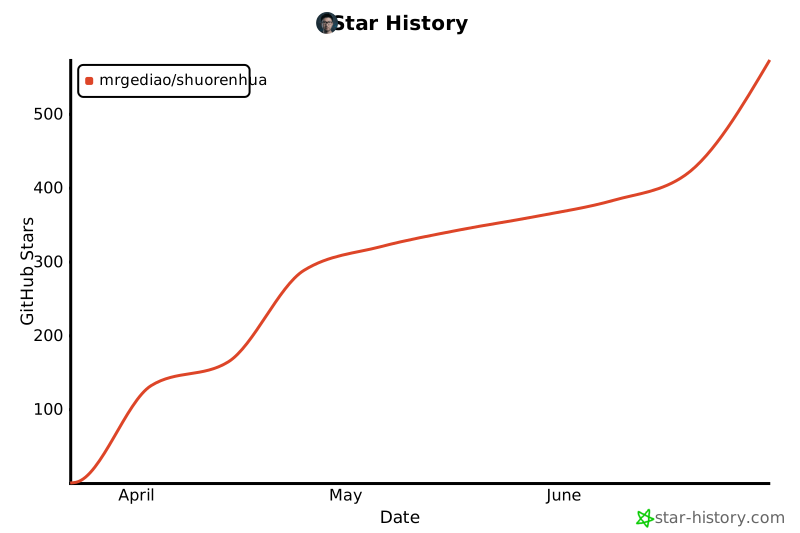
スター履歴
ライセンス
MIT