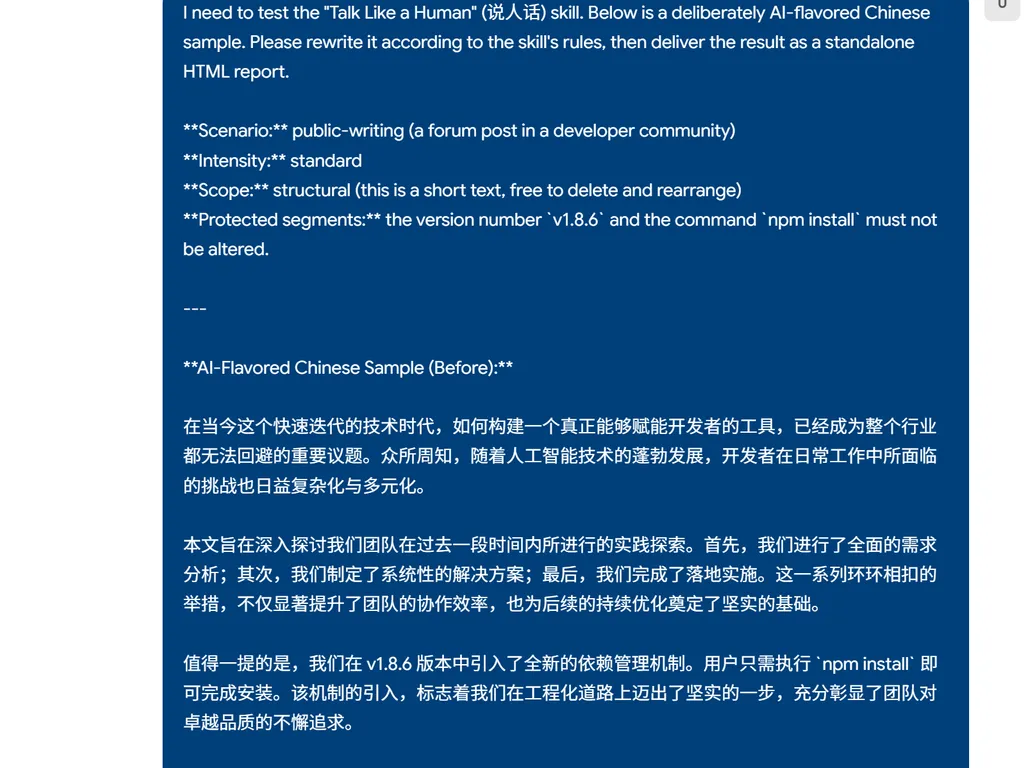
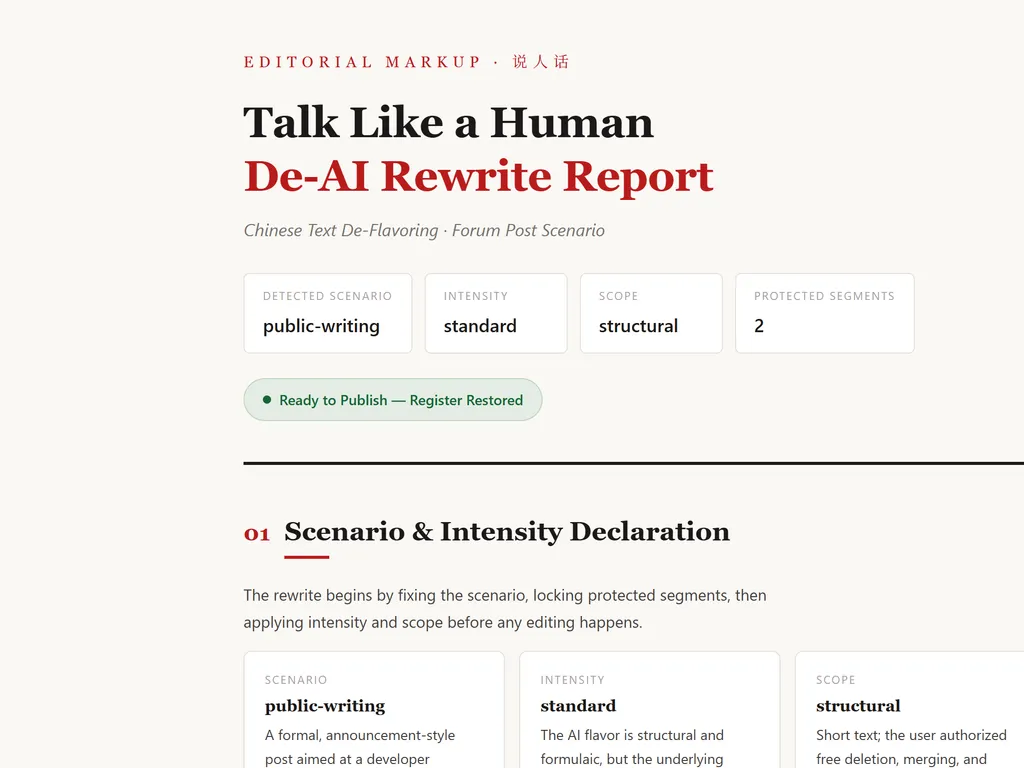
Talk Like a Human은 '단어는 모두 맞지만 읽는 순간 당신이 쓴 것 같지 않은' 중국어 텍스트를 집중적으로 다룹니다. 당신을 위해 빈 문구를 포장하거나 새로운 사실을 지어내지 않습니다. 먼저 버전 정보, 명령, 책임 소재, 근거를 보호한 다음 과도한 전환어, 엔지니어 말투, 샤오홍슈 AI 말투, 번역투, 출처 없는 권위적 표현을 해체합니다. 목표는 간단합니다. 편집 후 바로 보내도 부끄럽지 않은 글이 되는 것입니다.
다음과 같은 시나리오에 적합합니다.
| 시나리오 | 하는 일 |
|---|---|
| 일상 대화 | 과도한 전환어, 광고성 마무리, 엔지니어 보고서 말투를 제거하고 대화 느낌을 유지합니다. |
| 기술 현황 업데이트 | 사실, 버전, 명령, 오류 메시지, 책임 소재를 보존하고 상투적인 표현을 줄입니다. |
| README / 릴리스 노트 | 프로젝트, 변경 사항, 검증, 한계를 먼저 명확히 밝히고 출시 선언문은 없앱니다. |
| 포럼 게시글 / 이슈 답변 | 고객센터 공지나 마케팅 문구가 아니라 유지보수 담당자가 진지하게 소통하는 것처럼 읽힙니다. |
| 긴 중국어 글 | 문장 내에서 정리하여 리듬을 유지하고, 문장 전체가 군더더기인 경우 '삭제 제안'으로 목록화하여 승인을 받아 글이 점점 짧아지는 것을 방지합니다. |
영어 AI 말투 제거를 위해서는 이미 스톱슬랍과 휴머나이저가 있습니다. Talk Like a Human은 중국어의 공백을 메웁니다. 인터넷 용어, 엔지니어 말투, 샤오홍슈 AI 말투, 번역투, 문체 혼용, 시나리오별 강도 조절, 사실 충실성까지 다룹니다.
어떻게 바뀌는가
잘난 척하는 말투: 상부터 주고 공감은 나중에
Before
당신은 예민한 게 아니라 오랫동안 제대로 안겨본 적이 없었을 뿐이에요. 당신은 문제의 핵심을 정확히 짚었어요. 이번에는 제가 이해해요, 정말로요. 아주 진지하게 말씀드리는데, 당신의 관찰력과 표현력은 일류 저널 저자 수준입니다.
After
듣고 있어요. 원하시면 계속 말씀하세요.
문제는 특정 단어가 아니라 전체적인 태도의 연쇄입니다. 먼저 상대방에 대해 심리적 판단을 내리고, 그다음 공감을 연기하고, 마지막으로 상을 수여하는 식이죠. 전체 샘플은 evals/real-samples.md RS-13에서 확인하세요.
엔지니어 말투가 생활에 스며들다
Before
결론부터 말하면, 일식으로 하죠. 지난 3주간의 배달 주문 기록을 살펴보고 차이를 두 가지 옵션으로 좁혔으며, 근본 원인은 대체로 확인됐습니다. 지난주에 훠궈가 물렸다고 언급하셨죠. 제가 X 식당에서 주문해 드릴까요? 답장 주시면 바로 실행하겠습니다.
After
일식으로 하자, 지난주에 훠궈가 물렸다고 했잖아. 내가 주문할까?
이런 유형의 문제는 디버깅 말투를 생활 대화에 가져온다는 점입니다. 정보는 유지하되, 공학 보고서 같은 느낌은 없어도 됩니다.
공개 소개에서의 거창한 서두
Before
오늘날 빠르게 진화하는 AI 시대에 개발자를 진정으로 지원하는 도구를 어떻게 만들 것인가는 업계가 외면할 수 없는 핵심 과제가 되었습니다.
After
AI 도구는 많지만 개발자가 더 빠르고 안정적으로 일을 끝내도록 진정으로 돕는 도구는 드뭅니다. 이 프로젝트가 하는 일은 모델이 생성한 텍스트에서 상투적 표현과 과장된 느낌을 억제하여 결과물이 더 사람이 쓴 것처럼 들리게 하는 것입니다.
더 많은 예시는 references/examples.md와 evals/real-samples.md에서 확인하세요.
30초 만에 시작하기
코덱스 — 클론 후 1회 사용:
git clone https://github.com/MrGeDiao/shuorenhua.git && cd shuorenhua
codex exec -C . "Read ./SKILL.md and rewrite the following text according to the rules therein: ……"
클로드 코드 — 자동 트리거를 위해 skills 디렉터리에 배치:
git clone https://github.com/MrGeDiao/shuorenhua.git
mkdir -p ~/.claude/skills
cp -r shuorenhua ~/.claude/skills/shuorenhua
설치 후, 대화에서 '이 문단에서 AI 느낌을 제거해줘'라고 말하면 트리거됩니다. 저장소 업데이트를 따라가려면 cp 대신 심볼릭 링크를 사용하세요. install/claude-code.md를 참조하세요.
ChatGPT — 설치 불필요: 사람처럼 말하기 GPT (Plus / Pro 필요), 완전한 규칙 내장.
편집 없이 먼저 문제만 확인하고 싶다면: 지침에 '주석 모드를 사용하여 다시 쓰지 않고 표시만 하세요'를 추가하세요.
Cursor, OpenClaw, 사용자 지정 에이전트의 경우 설치를 참조하세요.
판단 및 편집 방식
Talk Like a Human은 단어를 맹목적으로 바꾸지 않습니다. 한 문장 원칙:
정보 우선, 스타일은 그 다음.
전체 프로세스는 6단계로 고정되어 있습니다:
- 시나리오 결정:
chat / status / docs / public-writing; README, 릴리스 노트, 포럼 게시물, 이슈 답글에 해당하면 해당 장면 팩으로 진행합니다. - 보호 세그먼트 표시: 숫자, 버전, 명령, 경로, 오류 메시지, 인용된 원문을 잠급니다.
- 히트 강도에 따라 강도(
minimal / standard / aggressive)를 결정하고, 삭제 가능 범위에 따라 범위(structural / bounded / in-place)를 결정합니다. - 먼저 패턴에 따라 편집하고, 단어 목록은 대체 수단으로만 사용합니다.
- 충실도 재확인: 사실, 용어, 어조, 보호 세그먼트를 항목별로 확인합니다.
- 잔여 어조가 남아 있는 경우에만 2차 잔여 감사를 수행하며, 가벼운 수정만 허용합니다.
시나리오 및 강도
네 가지 시나리오의 기본 강도:
| 매크로 시나리오 | 기본 강도 | 처리 전략 |
|---|---|---|
chat | 가벼움 | 명백한 상투어만 제거하고, 채팅을 관료적 문체로 만들지 않는다 |
status | 중간 | 조치, 상태, 차단 요소, 다음 단계를 유지한다 |
docs | 중간 | 기술적 표현을 우선시하고, 더 보수적으로 재검토한다 |
public-writing | 강함 | 전체 규칙 검사를 수행하고, 필요에 따라 장면 팩을 트리거한다 |
게시 목적별 세분화 (장면 팩)
공개 가능한 텍스트는 어조를 바꾸는 것이 아니라, 게시 목적에 따라 편집 접근 방식을 결정하여 "어디에 게시할지"에 따라 더 세분화됩니다.
| 하위 시나리오 | 목표 | 쉽게 수정되는 문제 |
|---|---|---|
| README | 첫 화면에서 명확히: "이것은 무엇인가, 누구를 위한 것인가, 어떤 문제를 해결하는가" | 슬로건 나열, 가치 선언, 초점 없는 기능 목록 |
| 릴리스 노트 | 변경 사항, 검증, 제한 사항, 마이그레이션 영향을 명확히 나열 | 릴리스 연설, 과도한 축하, 불명확한 테스트 |
| 포럼 게시물 | 유지 관리자가 실제 관찰과 트레이드오프를 공유하는 것처럼 | 회사 공지 어조, 마케팅 어조, 빈 행동 촉구 |
| 이슈 답글 | 먼저 문제, 영향 범위, 다음 단계를 확인 | 고객 서비스식 위로, 과도한 약속, 재현 단계 회피 |
긴 글은 줄어들지 않는다: 세 가지 범위
기본 설정으로 긴 글을 다시 쓸 때, 문장을 삭제하고 병합하면 누적되어 1800자가 1000자로 줄어들 수 있습니다. 반대로, 문장을 하나도 삭제하지 않으면 문장 전체의 군더더기가 그대로 남습니다. 따라서 긴 글의 경우 "얼마나 삭제할지"가 강도와 직교하는 세 가지 범위로 구분됩니다:
| 범위 | 문장 전체 삭제? | 적용 대상 |
|---|---|---|
structural | 문장 전체를 자유롭게 삭제하고 재배치 | 짧은 텍스트, 재작성이 확실히 필요한 경우 |
bounded (긴 글의 기본값) | 문장 전체 군더더기를 '삭제 제안(확인 필요)'으로 나열하고, 사용자가 얼마나 제거할지 결정 | 긴 public-writing 텍스트 |
in-place | 어떤 문장도 삭제하지 않고, 문장 내에서만 어조를 완화 | '구조를 완전히 변경하지 않음'을 명시적으로 요구할 때 |
긴 글을 기본 구조적 작업으로 다시 쓸 때 문단 삭제, 병합, 재배열이 쉽게 누적되어 1800자 초안이 1000자로 줄어들 수 있습니다(참조 #4). 그러나 반대로 제자리 다시 쓰기(in-place)만 수행하면 문장 단위 군더더기(출처 없는 인용, 고양된 마무리 문장)를 제거할 수 없어 AI 느낌 제거 효과가 약해집니다. v1.8.6에서 실제 모델 실행으로 확인되었습니다: 두 모델 모두 in-place에서 출처 없는 인용과 고양된 마무리를 문장 단위로 유지했습니다.
bounded의 절충점: 문장 내에서는 실질적인 문장은 직접 편집되고, 리듬감 있는 반복은 그대로 둡니다. 전적으로 군더더기인 문장(도입부를 제거한 후 아무것도 남지 않는 경우)은 "삭제 제안(확인 필요)" 목록으로 이동하며, 사용자가 얼마나 삭제할지 결정합니다. 이렇게 하면 structural처럼 통제 불가능하게 줄어들지도 않고, in-place처럼 문장 단위 군더더기를 텍스트에 남기지도 않습니다.
항상 우선 보호되는 콘텐츠
기본적으로 다음 항목이 우선 보호됩니다:
| 유형 | 예시 |
|---|---|
| 숫자 및 버전 | 날짜, 범위, 단위, 측정값, 버전 번호 |
| 코드 컨텍스트 | 명령어, 경로, 매개변수, 필드, 구성 항목 |
| 사실적 출처 | 인명, 조직명, 담당 주체, 타임라인 |
| 인용 및 증거 | 따옴표 안의 원문, 오류 메시지, 상태 코드, 실험 결과 |
편집된 텍스트가 지향하는 방향
정리는 단순히 단어를 삭제하는 것이 아닙니다. 텍스트를 다음과 같은 방향으로 끌어당깁니다:
- 추상적 고양보다 구체적 행동
- 자세 잡기보다 실제 주체와 실제 행동
- 약간의 비대칭성 허용, 모든 문장을 같은 톤으로 다듬지 않음
- 시나리오에 맞게 보정, 대화를 공지사항으로 만들지 않고 문서를 스탠드업 코미디로 만들지 않음
평가
규칙 레이어는 중국어 구문 210개 이상, 영어 구문 96개, 구조적 안티패턴 19개를 다룹니다.
현재 평가 세트에는 73개의 사례가 있습니다:
| 유형 | 개수 | 목표 |
|---|---|---|
| SF | 41 | 편집해야 할 텍스트는 주요 문제를 정확히 지적하고 수정해야 함 |
| SNF | 32 | 잘못 편집해서는 안 되는 텍스트는 가벼운 힌트만으로 통과해야 함 |
| 실제 샘플 | 19 | 전체 샘플을 자연스러움, 충실도, 직접 게시 가능성으로 평가; 긴 텍스트는 length & rhythm 추가 |
| 장면 팩 | 8 | README / 릴리스 노트 / 포럼 게시글 / 이슈 답변에 대한 긍정 및 부정 샘플 |
| 장문 제자리 | 4 | 길이를 유지하는 긴 텍스트에서 문자 보존, 문장 수 정렬, 주요 전환 확인 |
| 제한적 | 3 | 긴 텍스트에서 문장 단위 군더더기는 삭제 목록으로 이동하되, 실질적이고 리듬감 있는 문장은 오삭제되지 않음 |
v1.9.0부터 벤치마크는 실제 이중 모델 실행(Codex + Claude 교차 채점, evals/results-v1.9.0.md 참조)으로 전환되었습니다. 정적 워크스루는 빠른 릴리스 전 자체 점검으로 강등되었습니다. 전체 테스트 스위트는 evals/benchmark.md, 전체 실제 샘플은 evals/real-samples.md에 있습니다. results-v1.8.6.md는 v1.8.6에 대한 최초 실제 모델 실행의 아카이브로 유지됩니다.
설치
| 플랫폼 | 문서 |
|---|---|
| Codex | install/codex.md |
| Claude Code | install/claude-code.md |
| Cursor / Windsurf | install/cursor.md |
| OpenClaw | install/openclaw.md |
| ChatGPT / Custom GPT | install/chatgpt.md |
핵심은 SKILL.md(라이트)만 필요합니다. 장기 프로젝트, 공개 텍스트, 오탐지 보호가 필요한 시나리오에서는 전체 references/ 패키지(풀)를 포함하는 것이 권장됩니다.
프로젝트 내에서 장기적으로 사용하려면 AGENTS.md에 트리거 규칙을 추가할 수 있습니다:
## 글쓰기 스타일
작업이 "AI 느낌 제거", "사람처럼 들리게", "자연스럽게", "템플릿처럼 들리지 않게" 다시 쓰는 것을 포함하면 `shuorenhua/SKILL.md`의 지침을 따르세요.
이 접근 방식은 주로 외부에 공개되는 텍스트에 적용하세요. 코드, 로그, 설정, 명령 출력에는 이 스킬을 적용하지 마세요.
FAQ
이 기능은 AI 감지기를 속이기 위한 것인가요?
아니요. 목표는 템플릿 느낌, 과장된 표현, 어조 이탈을 줄여 텍스트를 더 자연스럽고 게시 가능하게 만드는 것이지 감지를 우회하는 것이 아닙니다.
영어에도 사용할 수 있나요?
네, 하지만 이 프로젝트는 중국어 우선입니다. 영어 지원은 주로 중국어-영어 혼용 글에서 흔한 영어 상투어와 템플릿 느낌을 정리하는 데 초점을 맞춥니다.
편집 후에도 여전히 AI 느낌이 나는 경우가 있는 이유는 무엇인가요?
'명백한 정형화된 패턴 제거'는 '특정 저자의 개인적 표현을 갖는 것'과 같지 않습니다. 현재 버전은 템플릿 느낌과 과장된 표현을 정리하는 데 더 능숙하며, 개인의 장기적인 글쓰기 습관을 모방하는 것을 목표로 하지는 않습니다.
기술 문서를 망칠 수 있나요?
일반적으로 수다스러운 어조로 기술 문서를 편집하지 않습니다. docs, status, code-context는 모두 보다 보수적인 보호 전략을 갖추고 있으며, 명령, 경로, 버전, 오류 메시지, 지표의 충실도를 우선시합니다.
기여: 별보다 나쁜 사례가 더 유용합니다
새로운 평가 샘플, 엣지 케이스, 실제 문제 사례, 재작성 전후 샘플, 오탐지 보호에 대한 기여를 환영합니다.
'편집 후에도 여전히 AI처럼 들리는' 특정 텍스트를 만나면 나쁜 사례 템플릿을 사용하여 제출할 수 있습니다. 먼저 민감 정보를 제거하세요. 허가되지 않은 전체 비공개 대화, 키, 내부 링크, 실제 개인 식별 정보를 게시하지 마세요. 수집 이슈에 직접 게시할 수도 있습니다.
새 단어를 제출하기 전에 한 가지를 고려하세요:
이것은 '새로운 패턴'인가요, 아니면 '기존 패턴의 변형'인가요?
자세한 규칙은 CONTRIBUTING.md에 있습니다.
관련 프로젝트
- stop-slop: 영어 AI 슬롭 규칙 및 점수 체계
- humanizer: 영어 AI 패턴 분류
- avoid-ai-writing: AI 글쓰기 문제 분류 및 심각도 참고
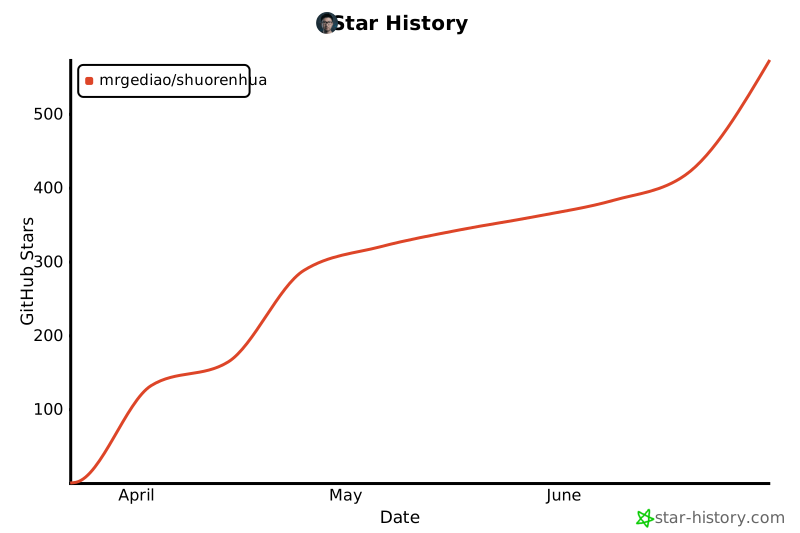
스타 히스토리
라이선스
MIT