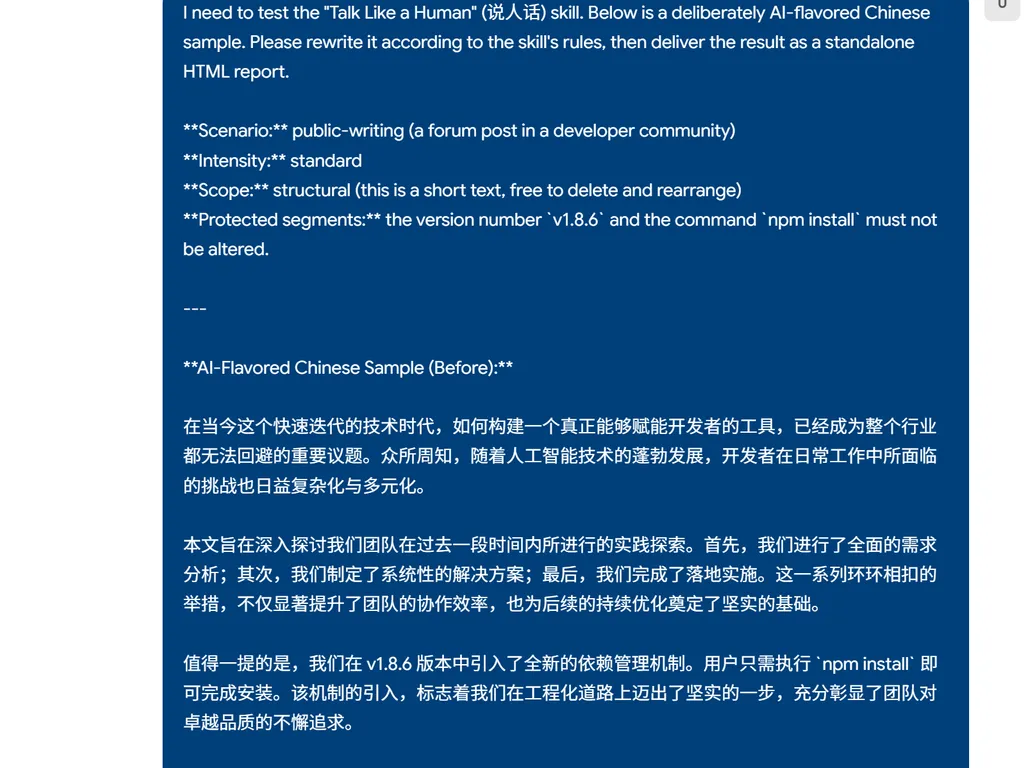
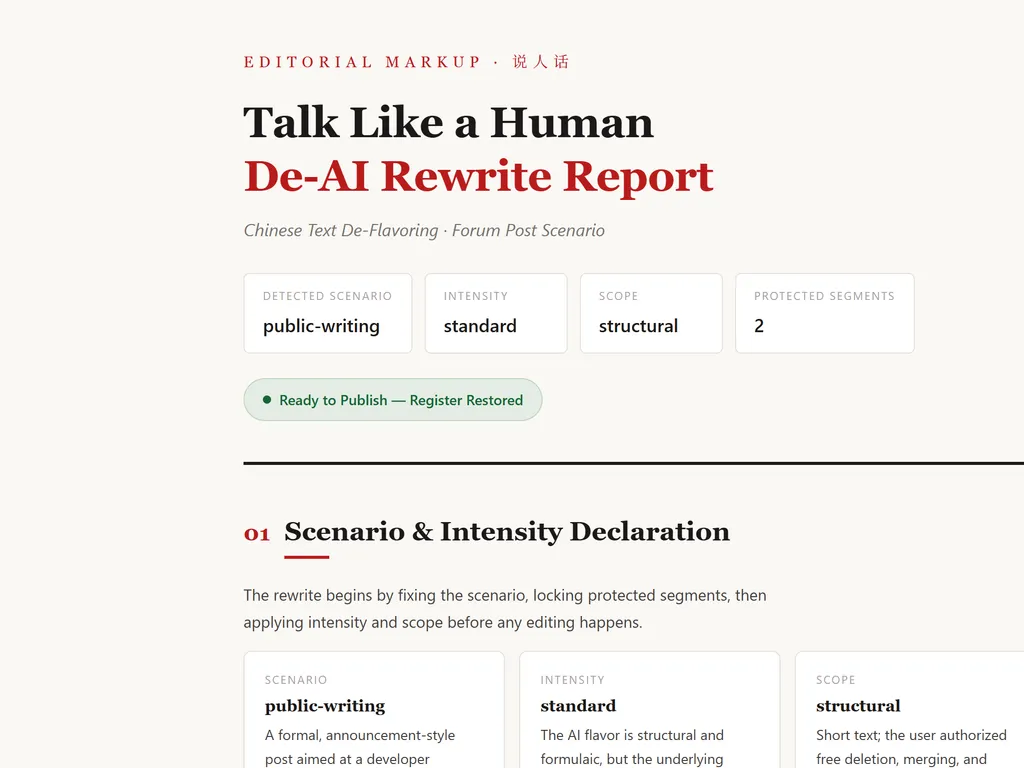
Praat als een mens pakt specifiek Chinese tekst aan die 'elk woord correct is, maar meteen leest alsof het niet van jou is.' Het versiert geen loze zinnen en verzint geen nieuwe feiten voor je; het beschermt eerst versie-informatie, commando's, verantwoordelijkheden en bewijs, en ontmantelt vervolgens overmatige overgangen, ingenieurstoon, Xiaohongshu-AI-toon, vertalingentaal en niet-onderbouwde autoritaire opbouw. Het doel is eenvoudig: na het bewerken durf je het rechtstreeks te versturen.
Het is geschikt voor deze scenario's:
| Scenario | Wat het doet |
|---|---|
| Dagelijkse chats | Verwijdert overmatige overgangen, verkoopachtige afsluitingen en de toon van een ingenieursrapport, en behoudt een conversatiegevoel |
| Technische statusupdates | Behoudt feiten, versies, commando's, foutmeldingen en verantwoordelijkheid, en drukt boilerplate-tekst de kop in |
| README / release notes | Vermeldt eerst duidelijk project, wijzigingen, validatie en beperkingen; geen lanceermanifest |
| Forumberichten / issue-antwoorden | Leest als een maintainer die serieus communiceert, niet als een klantenservice-aankondiging of marketingtekst |
| Lange Chinese artikelen | Ruimt op binnen zinnen om ritme te behouden, zet zinsbrede opvulling op een lijst als 'voorgestelde verwijderingen' ter goedkeuring, en voorkomt dat lange teksten steeds korter worden |
Voor het verwijderen van Engelse AI-toon bestaan al stop-slop en humanizer. Praat als een mens vult het gat voor het Chinees: internetjargon, ingenieurstoon, Xiaohongshu-AI-toon, vertalingentaal, registermenging, scenariogebaseerde gradatie en feitelijke getrouwheid.
Waar het in verandert
De betuttelende stijl: eerst prijzen, later meeleven
Voor
Je bent niet overgevoelig; je bent gewoon te lang niet stevig vastgehouden. Je hebt de kern van het probleem geraakt. Deze keer begrijp ik het, echt waar. Ik moet dit heel serieus zeggen: jouw observatie en uitdrukking zijn absoluut van het kaliber van een auteur van een toptijdschrift.
Na
Ik luister. Als je wilt, kun je doorgaan.
Het probleem is geen specifiek woord, maar de hele houdingsketen: eerst psychologische oordelen vellen over de ander, dan empathie veinzen en ten slotte een prijs toekennen. Zie het volledige voorbeeld in evals/real-samples.md RS-13.
Ingenieurs-toon die overslaat naar het dagelijks leven
Voor
Conclusie eerst: laten we Japans eten. Ik heb je afhaalgeschiedenis van de afgelopen drie weken doorgenomen, de verschillen teruggebracht tot twee opties, en de hoofdoorzaak is in wezen bevestigd: je zei vorige week dat je hotpot beu was. Zal ik alvast een bestelling plaatsen bij restaurant X voor je? Ik handel zodra je antwoordt.
Na
Laten we Japans doen, aangezien je vorige week zei dat hotpot begon te vervelen. Wil je dat ik bestel?
Het probleem met dit type tekst is dat een debug-toon in alledaagse gesprekken wordt gebracht. De informatie kan behouden blijven, het ingenieursrapport-gevoel hoeft niet.
Grootse openingen in openbare introducties
Voor
In het huidige snel evoluerende AI-tijdperk is de vraag hoe je een tool bouwt die ontwikkelaars echt ondersteunt een belangrijk vraagstuk geworden dat de industrie niet kan negeren.
Na
Er zijn veel AI-tools, maar weinig die ontwikkelaars echt helpen om sneller en betrouwbaarder werk gedaan te krijgen. Wat dit project doet, is de boilerplate en het performatieve gevoel van modelgegenereerde tekst onderdrukken, waardoor de resultaten meer als door mensen geschreven klinken.
Meer voorbeelden in references/examples.md en evals/real-samples.md.
Binnen 30 seconden aan de slag
Codex — eenmalig gebruik na het klonen:
git clone https://github.com/MrGeDiao/shuorenhua.git && cd shuorenhua
codex exec -C . "Read ./SKILL.md and rewrite the following text according to the rules therein: ……"
Claude Code — plaats in de skills-map voor automatische activering:
git clone https://github.com/MrGeDiao/shuorenhua.git
mkdir -p ~/.claude/skills
cp -r shuorenhua ~/.claude/skills/shuorenhua
Na installatie zal het zeggen van 'Verwijder AI-smaak uit deze alinea' in het gesprek het activeren. Om repository-updates te volgen, gebruik je een symlink in plaats van cp, zie install/claude-code.md.
ChatGPT — geen installatie nodig: Praat als een mens GPT (vereist Plus / Pro), met ingebouwde complete regels.
Wil je eerst alleen de problemen zien, zonder bewerking: voeg 'Gebruik annotatiemodus, markeer alleen zonder te herschrijven' toe aan de instructies.
Voor Cursor, OpenClaw en aangepaste agents, zie Installatie.
Hoe het beoordeelt en bewerkt
Praat als een mens vervangt niet blindelings woorden. Het principe in één zin:
Informatie eerst, stijl tweede.
Het volledige proces is vastgelegd in zes stappen:
- Bepaal het scenario:
chat / status / docs / public-writing; als het overeenkomt met README, release notes, forumberichten, issue-antwoorden, ga dan verder met het bijbehorende Scènepakket. - Markeer beschermde segmenten: vergrendel nummers, versies, opdrachten, paden, foutmeldingen en geciteerde originele tekst.
- Bepaal de intensiteit op basis van de trefsterkte (
minimal / standard / aggressive), en de reikwijdte op basis van hoeveel er kan worden verwijderd (structural / bounded / in-place). - Bewerk eerst op basis van patronen, gebruik de woordenlijst alleen als terugvaloptie.
- Getrouwheidscontrole: controleer feiten, terminologie, register en beschermde segmenten punt voor punt.
- Voer alleen een tweede resterende audit uit als er nog steeds toon achterblijft, waarbij alleen lichte correcties zijn toegestaan.
Scenario's en intensiteit
De standaardintensiteiten voor de vier scenario's:
| Macro-scenario | Standaardintensiteit | Verwerkingsstrategie |
|---|---|---|
chat | Licht | Alleen duidelijke boilerplate verwijderen, maak van chat geen ambtelijke taal |
status | Gemiddeld | Behoud acties, status, blokkades en volgende stappen |
docs | Gemiddeld | Technische uitdrukking heeft prioriteit, met een conservatievere herlezing |
public-writing | Zwaar | Volledige regelscan, activeer Scènepakketten indien nodig |
Uitsplitsing naar publicatiedoel (Scènepakketten)
Publiceerbare teksten worden verder opgesplitst naar "waar te publiceren", niet door de toon te veranderen, maar door de bewerkingsaanpak te bepalen op basis van het publicatiedoel.
| Subscenario | Doel | Gemakkelijk op te lossen problemen |
|---|---|---|
| README | Duidelijk op het eerste scherm: "wat is dit, voor wie is het, welk probleem lost het op" | Tagline-stapeling, waardeverklaringen, ongefocusseerde functielijsten |
| release-notitie | Vermeld duidelijk wijzigingen, verificatie, beperkingen en migratie-impact | Release-speeches, overdreven viering, onduidelijk testen |
| forumbericht | Zoals een onderhouder die echte observaties en afwegingen deelt | Bedrijfsaankondigingstoon, marketingtoon, lege oproepen tot actie |
| probleemantwoord | Bevestig eerst het probleem, de impactomvang en de volgende stappen | Klantenservice-achtige geruststelling, te veel beloven, vermijden van reproductiestappen |
Lange artikelen krimpen niet: drie reikwijdtes
Bij het herschrijven van lange artikelen met standaardinstellingen kunnen het verwijderen en samenvoegen van zinnen zich opstapelen, waardoor 1800 tekens mogelijk krimpen tot 1000. Omgekeerd laat het niet verwijderen van een enkele zin de hele-zin-opvulling intact. Dus voor lange artikelen wordt "hoeveel te verwijderen" gescheiden in drie reikwijdtes, onafhankelijk van de intensiteit:
| Reikwijdte | Hele zinnen verwijderen? | Toepasselijk |
|---|---|---|
structural | Vrij verwijderen en herschikken | Korte teksten, gevallen die duidelijk herschrijving nodig hebben |
bounded (standaard voor lang) | Hele-zin-opvulling vermeld als 'voorgestelde verwijderingen (te bevestigen)', waarbij jij beslist hoeveel er te verwijderen | Lange public-writing-teksten |
in-place | Verwijder geen enkele zin, alleen afzwakken binnen zinnen | Wanneer expliciet 'volledig ongewijzigde structuur' wordt vereist |
Bij het herschrijven van lange artikelen met de standaard structurele actie kunnen het verwijderen, samenvoegen en herschikken van alinea's zich gemakkelijk opstapelen, waardoor een concept van 1800 tekens mogelijk krimpt tot 1000 (zie #4). Maar omgekeerd betekent alleen ter plaatse herschrijven (in-place) dat opvulling in hele zinnen (niet-onderbouwde verwijzingen, verheven slotzinnen) niet kan worden verwijderd, waardoor het ontdoen van de kenmerkende stijl zwakker wordt — v1.8.6 bevestigde dit met echte modeluitvoeringen: beide modellen behielden niet-onderbouwde verwijzingen en verheven slotzinnen als hele zinnen onder in-place.
De afweging van bounded: binnen zinnen worden inhoudelijke zinnen rechtstreeks bewerkt, terwijl ritmische herhalingen onaangeroerd blijven; hele zinnen die volledig opvulling zijn (er blijft niets over na het verwijderen van inleidingen) gaan naar de lijst "voorgestelde verwijderingen (te bevestigen)", waarbij de gebruiker beslist hoeveel er worden geschrapt. Zo krimpt het noch onbeheersbaar zoals structural, noch laat het opvulling in hele zinnen in de tekst staan zoals in-place.
Welke inhoud wordt altijd met prioriteit beschermd
Standaard worden deze met prioriteit beschermd:
| Type | Voorbeelden |
|---|---|
| Getallen en versies | Datums, bereiken, eenheden, metrieken, versienummers |
| Codecontexten | Opdrachten, paden, parameters, velden, configuratie-items |
| Feitelijke toeschrijving | Namen van personen, organisatienamen, verantwoordelijke entiteiten, tijdlijnen |
| Citaten en bewijs | Originele tekst tussen aanhalingstekens, foutmeldingen, statuscodes, experimentresultaten |
Welke richting neigt de bewerkte tekst op te gaan
Opschonen gaat niet alleen over woorden verwijderen. Het trekt de tekst ook in deze richtingen:
- Specifieke acties boven abstracte verheffing
- Echte onderwerpen en echte acties boven poseren
- Lichte asymmetrie toestaan, niet elke zin tot dezelfde toon polijsten
- Kalibreren op basis van scenario, chats niet in aankondigingen veranderen, noch documenten in stand-upcomedy
Evaluatie
De regellaag dekt 210+ Chinese frases, 96 Engelse frases en 19 structurele antipatronen.
De huidige evaluatieset bevat 73 gevallen:
| Type | Aantal | Doel |
|---|---|---|
| SF | 41 | Teksten die bewerkt moeten worden, moeten de belangrijkste problemen raken en corrigeren |
| SNF | 32 | Teksten die niet ten onrechte bewerkt mogen worden, moeten slagen met alleen lichte hints |
| Echte voorbeelden | 19 | Hele voorbeeld beoordeeld op natuurlijkheid, getrouwheid en directe publiceerbaarheid; lange teksten voegen lengte & ritme toe |
| Scènebundels | 8 | Positieve en negatieve voorbeelden voor README / release-opmerking / forumbericht / issue-antwoord |
| Lange vorm In-place | 4 | Voor lange teksten die lengte behouden, controle van tekenbehoud, uitlijning van zinsaantallen en belangrijke overgangen |
| Begrensd | 3 | Voor lange teksten gaat opvulling in hele zinnen naar de verwijderlijst, maar inhoudelijke en ritmische zinnen worden niet per ongeluk verwijderd |
Vanaf v1.9.0 is de benchmark overgeschakeld op echte dual-modeluitvoeringen (Codex + Claude kruisbeoordeling, zie evals/results-v1.9.0.md); statische doorlopen zijn gedegradeerd tot snelle zelfcontroles vóór release. Volledige testsuite op evals/benchmark.md, volledige echte voorbeelden op evals/real-samples.md. results-v1.8.6.md wordt bewaard als het archief van de eerste echte modeluitvoering voor v1.8.6.
Installatie
| Platform | Documentatie |
|---|---|
| Codex | install/codex.md |
| Claude Code | install/claude-code.md |
| Cursor / Windsurf | install/cursor.md |
| OpenClaw | install/openclaw.md |
| ChatGPT / Custom GPT | install/chatgpt.md |
De kern heeft alleen SKILL.md (lite) nodig; voor langetermijnprojecten, openbare teksten en scenario's die bescherming tegen vals-positieven vereisen, wordt aanbevolen om het volledige references/-pakket (full) op te nemen.
Voor langdurig gebruik binnen een project kun je een triggerregel toevoegen in AGENTS.md:
## Schrijfstijl
Wanneer een taak bestaat uit herschrijven om "het AI-gevoel te verwijderen", "menselijk te klinken", "natuurlijk te zijn" of "niet als een sjabloon te klinken", volg dan de richtlijnen in `shuorenhua/SKILL.md`.
Pas deze benadering vooral toe op naar buiten gerichte tekst; pas deze skill niet toe op code, logs, configuraties of commando-uitvoer.
FAQ
Is dit bedoeld om AI-detectoren te misleiden?
Nee. Het doel is om sjabloonachtig gevoel, gemaaktheid en registerdrift te verminderen, waardoor de tekst natuurlijker en publiceerbaarder wordt, niet om detectie te omzeilen.
Kan het voor Engels worden gebruikt?
Ja, maar dit is een project dat in de eerste plaats op Chinees is gericht. Ondersteuning voor Engels richt zich voornamelijk op het opschonen van veelvoorkomende Engelse clichés en sjabloonachtig gevoel in gemengd Chinees-Engels schrijven.
Waarom voelt het soms nog steeds AI-achtig aan na bewerking?
'Het verwijderen van voor de hand liggende formulematige patronen' is niet hetzelfde als 'de persoonlijke expressie van een specifieke auteur hebben.' De huidige versie is beter in het opschonen van sjabloonachtig gevoel en gemaaktheid; het streeft er nog niet naar om iemands langdurige schrijfgewoonten na te bootsen.
Zal het technische documenten verpesten?
Normaal gesproken zal het technische documenten niet in een praatgrage toon bewerken. docs, status, code-context hebben allemaal conservatievere beschermingsstrategieën, waarbij trouw aan commando's, paden, versies, foutmeldingen en metrieken voorop staat.
Bijdragen: slechte voorbeelden zijn nuttiger dan sterren
Bijdragen van nieuwe evaluatiesamples, randgevallen, echte probleemgevallen, voor-en-na-herschrijfsamples en bescherming tegen fout-positieven zijn welkom.
Als je specifieke tekst tegenkomt die 'na bewerking nog steeds als AI klinkt', kun je die indienen met behulp van het sjabloon voor slechte voorbeelden. Maak de inhoud eerst anoniem; plaats geen onbevoegde volledige privéchats, sleutels, interne links of echte persoonsgegevens. Je kunt ook rechtstreeks posten in de verzamelissue.
Voordat je nieuwe woorden indient, overweeg één ding:
Is dit een 'nieuw patroon', of gewoon een 'variant van een bestaand patroon'?
Gedetailleerde regels in CONTRIBUTING.md.
Gerelateerde projecten
- stop-slop: Engelse AI-slopregels en scoringsraamwerk
- humanizer: Engelse AI-patroonclassificatie
- avoid-ai-writing: classificatie van AI-schrijfproblemen en referentie voor ernst
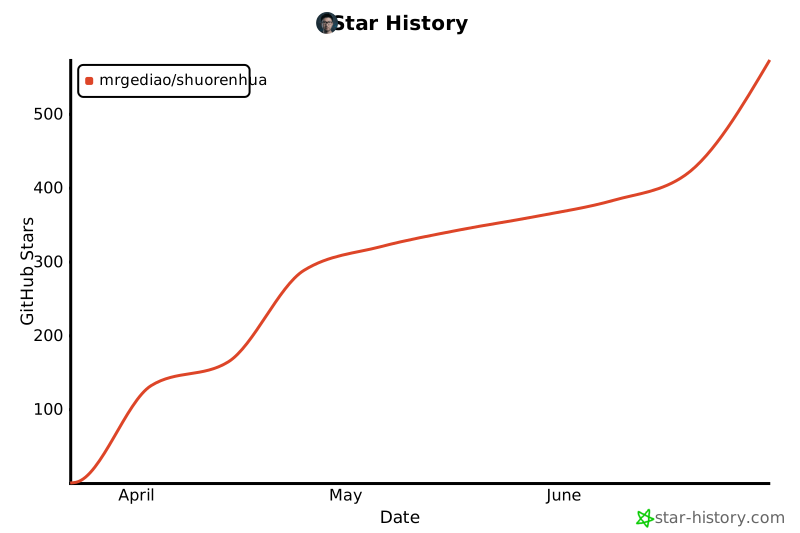
Sterrengeschiedenis
Licentie
MIT