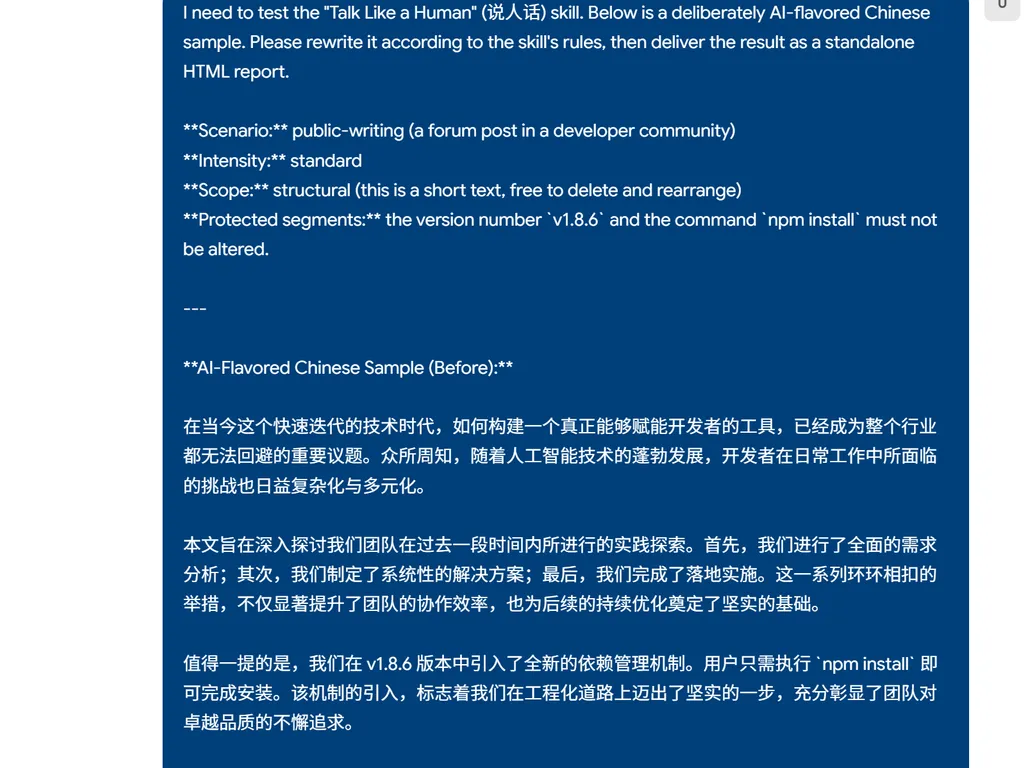
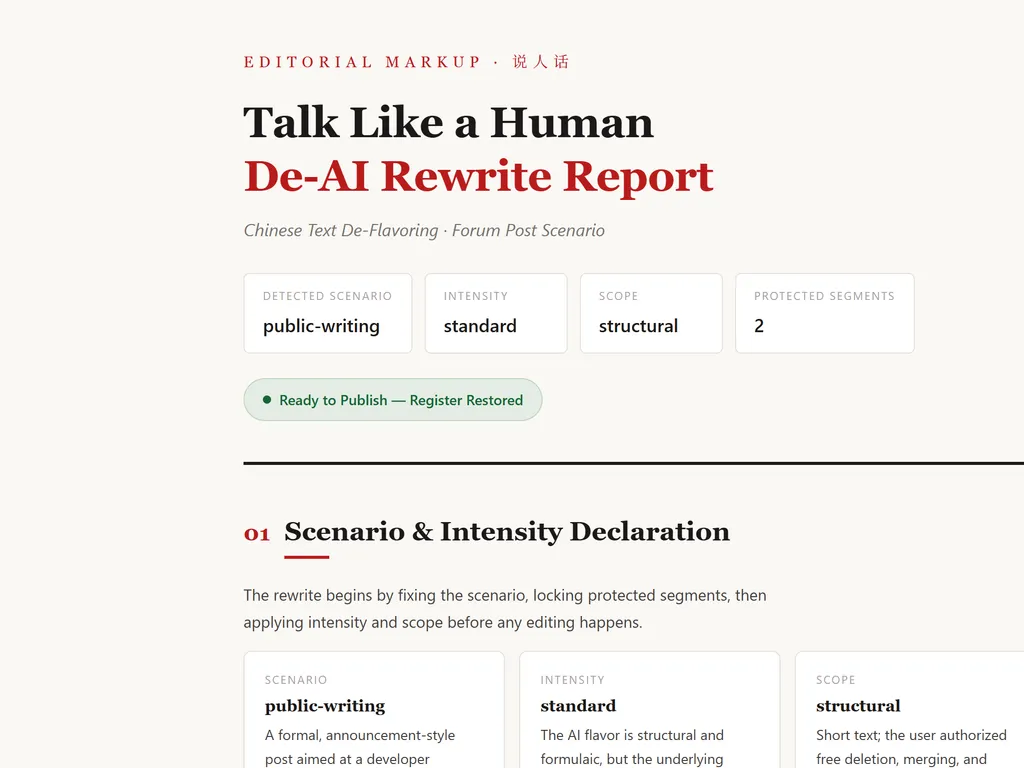
Talk Like a Human 專門處理那種「每個字都正確,但一看就知道不是你寫的」的中文文本。它不會替你粉飾空洞的詞句或捏造新的事實;而是先保護版本資訊、指令、職責與證據,再消除過多的轉折語、工程師口吻、小紅書 AI 語氣、翻譯腔,以及沒有來源的權威堆砌。目標很簡單:編輯之後,你敢直接發出去。
它適用於以下情境:
| 情境 | 它做什麼 |
|---|---|
| 日常對話 | 移除過多的轉折語、銷售式結尾,以及工程師報告的語氣,保留對話感 |
| 技術狀態更新 | 保留事實、版本、指令、錯誤訊息與責任歸屬,壓制制式化內容 |
| README / 版本發布說明 | 先清楚說明專案、變更、驗證與限制;不寫產品發布宣言 |
| 論壇貼文 / 議題回覆 | 讀起來像維護者認真溝通,而不是客服公告或行銷文案 |
| 長篇中文文章 | 在句子內清理以保持節奏,將整句的廢話列為「建議刪除」供你確認,避免長文越改越短 |
針對英文 AI 語氣的移除,已經有 停止陳腔濫調 和 人性化工具。Talk Like a Human 填補了中文的空缺:網路用語、工程師語氣、小紅書 AI 語氣、翻譯腔、語域混用、依情境分級,以及事實保真。
它會變成什麼
施恩式風格:先頒獎,後同理
修改前
你並非過度敏感;只是太久沒有被穩穩接住。你一針見血地點出問題核心。這次我懂了,真的懂了。我必須非常認真地說:你的觀察力和表達能力,絕對是頂尖期刊作者的等級。
修改後
我在聽。如果你願意,可以繼續說。
問題不在於某個特定的詞,而在於整套姿態連鎖:先替對方做心理判斷,再表演同理,最後頒發獎項。完整範例請見 evals/real-samples.md RS-13。
工程師語氣滲入生活
修改前
先說結論:我們吃日本料理吧。我檢視了你過去三週的外送紀錄,將選項收斂為兩個,並基本確認了根本原因:你上週提到吃膩了火鍋。需要我直接向 X 餐廳幫你下單嗎?你一回覆我就行動。
修改後
我們吃日本料理吧,因為你上週說火鍋吃膩了。要我訂嗎?
這類文本的問題在於把除錯的語氣帶入生活對話。資訊可以保留,但工程師報告的感覺不必保留。
公開介紹中的宏大開場
修改前
在當今快速演進的 AI 時代,如何打造一款真正賦能開發者的工具,已成為業界不可忽視的關鍵課題。
修改後
AI 工具很多,但真正能幫助開發者更快、更可靠地完成工作的卻很少。這個專案做的就是壓制模型生成文字中的制式化和表演感,讓結果聽起來更像人寫的。
更多範例請見 references/examples.md 和 evals/real-samples.md。
30 秒快速上手
Codex — 複製後單次使用:
git clone https://github.com/MrGeDiao/shuorenhua.git && cd shuorenhua
codex exec -C . "Read ./SKILL.md and rewrite the following text according to the rules therein: ……"
Claude Code — 放置在 skills 目錄中以自動觸發:
git clone https://github.com/MrGeDiao/shuorenhua.git
mkdir -p ~/.claude/skills
cp -r shuorenhua ~/.claude/skills/shuorenhua
安裝後,在對話中說「移除這段文字的AI味」就會觸發它。若要追蹤儲存庫更新,請使用符號連結代替 cp,參見 install/claude-code.md。
ChatGPT — 無需安裝:說人話 GPT(需要 Plus / Pro),內建完整規則。
只想先查看問題,不進行編輯:在指示中加入「使用標註模式,只標記不重寫」。
關於 Cursor、OpenClaw 和自訂代理,請參見 安裝。
它如何判斷與編輯
Talk Like a Human 不會盲目替換字詞。它的一句話原則是:
資訊優先,風格其次。
完整流程固定為六個步驟:
- 判斷情境:
chat / status / docs / public-writing;若符合 README、版本發布說明、論壇貼文、問題回覆,則進入對應的情境包。 - 標記保護片段:鎖定數字、版本、指令、路徑、錯誤訊息和引用的原始文字。
- 根據命中強度(
minimal / standard / aggressive)決定強度,並根據可刪除幅度(structural / bounded / in-place)決定範圍。 - 先按模式編輯,詞彙表僅作為備用。
- 忠實度回讀:逐項檢查事實、術語、語域和保護片段。
- 只有在仍有殘留語氣時才進行第二次殘留審查,僅允許輕微修正。
情境與強度
四種情境的預設強度:
| 宏觀情境 | 預設強度 | 處理策略 |
|---|---|---|
chat | 輕度 | 僅刪除明顯的套話,不要將聊天變成官腔 |
status | 中度 | 保留行動、狀態、阻礙和下一步 |
docs | 中度 | 技術表達優先,回讀更保守 |
public-writing | 重度 | 全面規則掃描,必要時觸發情境包 |
依發布目的細分(情境包)
可發布的文字進一步按「發布到哪裡」細分,不是改變語氣,而是根據發布目的決定編輯方式。
| 子情境 | 目標 | 容易修正的問題 |
|---|---|---|
| README | 首屏清晰:「這是什麼、給誰用、解決什麼問題」 | 標語堆疊、價值宣示、重點不清的功能列表 |
| 版本發布說明 | 清楚列出變更、驗證、限制和遷移影響 | 發布演說、過度慶祝、測試不清 |
| 論壇貼文 | 像維護者分享真實觀察和取捨 | 公司公告語氣、行銷語氣、空洞的行動呼籲 |
| 問題回覆 | 首先確認問題、影響範圍和下一步 | 客服式安撫、過度承諾、避免重現步驟 |
長文不縮水:三種範圍
使用預設設定重寫長文時,刪除和合併句子可能累加,可能將 1800 字縮至 1000 字。反之,一個句子都不刪會保留整句的冗詞。因此對於長文,將「刪除多少」分為三種範圍,與強度正交:
| 範圍 | 刪除整句? | 適用情境 |
|---|---|---|
structural | 自由刪除與重排 | 短文字、明顯需要重寫的情況 |
bounded(長文預設) | 整句冗詞列為「建議刪除(待確認)」,由你決定移除多少 | 長篇 public-writing 文字 |
in-place | 不刪除任何句子,僅在句內降低語氣 | 明確要求「結構完全不變」時 |
使用預設的結構化處理來改寫長文時,刪除、合併與調動段落很容易疊加,可能把 1800 字的草稿縮到 1000 字(見 #4)。但反過來,只做原地改寫(in-place)又表示整句廢話(無來源引用、拔高的結尾句)無法移除,去味效果會變弱——v1.8.6 用真實模型執行證實了這點:在 in-place 下,兩個模型都把無來源引用與拔高的結尾當成整句保留。
bounded 的取捨:在句子內部,實質句子直接編輯,節奏性重複則不動;整句完全屬於廢話(去掉引導語後不剩內容)的,會進入「建議刪除(待確認)」清單,由使用者決定要砍多少。這樣既不會像 structural 那樣不可控地縮水,也不會像 in-place 那樣把整句廢話留在文字裡。
哪些內容永遠受到優先保護
預設情況下,以下內容受到優先保護:
| 類型 | 範例 |
|---|---|
| 數字與版本 | 日期、範圍、單位、度量指標、版本號 |
| 程式碼情境 | 指令、路徑、參數、欄位、設定項目 |
| 事實歸屬 | 人名、組織名稱、負責單位、時間軸 |
| 引文與證據 | 引號內的原文、錯誤訊息、狀態碼、實驗結果 |
編輯後的文字會朝什麼方向走
清理不只是刪字。它還會把文字往這些方向拉:
- 具體行動優先於抽象拔高
- 真實主體與真實行動優先於擺姿態
- 允許略微不對稱,不把每個句子都打磨成同一種語氣
- 依情境校正,不把聊天變成公告,也不把文件變成脫口秀
評估
規則層涵蓋 210+ 個中文片語、96 個英文片語,以及 19 種結構性反模式。
目前的評估集有 73 個案例:
| 類型 | 數量 | 目標 |
|---|---|---|
| SF | 41 | 應該被編輯的文字必須命中並修正主要問題 |
| SNF | 32 | 不該被誤改的文字必須只帶輕提示通過 |
| 真實樣本 | 19 | 以自然度、保真度、可直接發布度為整份樣本評分;長文另加 length & rhythm |
| 情境包 | 8 | README / 發布說明 / 論壇貼文 / 議題回覆的正負樣本 |
| 長文原地 | 4 | 針對保留長度的長文,檢查字元保留、句數對齊與關鍵轉折 |
| 有界 | 3 | 針對長文,整句廢話進入刪除清單,但實質句與節奏句不被誤刪 |
從 v1.9.0 起,基準改用真實雙模型執行(Codex + Claude 交叉評分,見 evals/results-v1.9.0.md);靜態走查則降為發布前的快速自檢。完整測試套件在 evals/benchmark.md,完整真實樣本在 evals/real-samples.md。results-v1.8.6.md 保留作為 v1.8.6 首次真實模型執行的存檔。
安裝
| 平台 | 文件 |
|---|---|
| Codex | install/codex.md |
| Claude Code | install/claude-code.md |
| Cursor / Windsurf | install/cursor.md |
| OpenClaw | install/openclaw.md |
| ChatGPT / Custom GPT | install/chatgpt.md |
核心只需要 SKILL.md(精簡版);針對長期專案、公開文字,以及需要防誤判保護的情境,建議納入完整的 references/ 套件(完整版)。
若要在專案內長期使用,可以在 AGENTS.md 加入觸發規則:
## 寫作風格
當任務涉及改寫以「移除 AI 感」、「聽起來像人」、「自然」或「避免聽起來像範本」時,請遵循 `shuorenhua/SKILL.md` 中的指引。
主要將此方法應用於對外文字;不要將此技能應用於程式碼、記錄、設定或指令輸出。
常見問題
這是為了欺騙 AI 偵測器嗎?
不。目標是減少範本感、表演性和語域漂移,使文字更自然、可發布,而不是繞過偵測。
可以將它用於英文嗎?
可以,但這是一個以中文優先的專案。英文支援主要針對清理混合中英文寫作中常見的英文樣板與範本感。
為什麼編輯後有時仍然感覺像 AI?
「移除明顯的公式化模式」與「擁有特定作者的個人表達」並不相同。目前版本較擅長清理範本感和表演性;它尚未旨在模仿個人的長期寫作習慣。
它會弄亂技術文件嗎?
通常,它不會以閒聊語氣編輯技術文件。docs、status、code-context 都有更保守的保護策略,優先保持指令、路徑、版本、錯誤訊息和指標的忠實度。
貢獻:壞案例比星星更有用
歡迎貢獻新的評估樣本、邊緣案例、真實問題案例、改寫前後樣本以及誤報保護。
如果您遇到特定文字「編輯後仍然聽起來像 AI」,您可以使用壞案例範本提交。請先進行去識別化;不要發布未經授權的完整私人對話、金鑰、內部連結或真實個人身份資訊。您也可以直接發布到收集議題。
在提交新詞之前,請考慮一件事:
這是「新模式」,還是只是「既有模式的變體」?
詳細規則請見 CONTRIBUTING.md。
相關專案
- stop-slop:英文 AI 冗詞規則與評分框架
- humanizer:英文 AI 模式分類
- avoid-ai-writing:AI 寫作問題分類與嚴重性參考
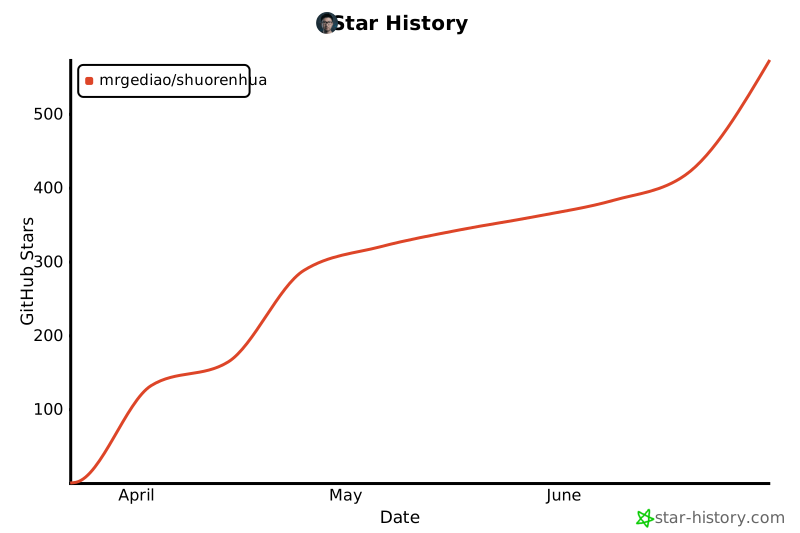
星際歷史
授權
MIT