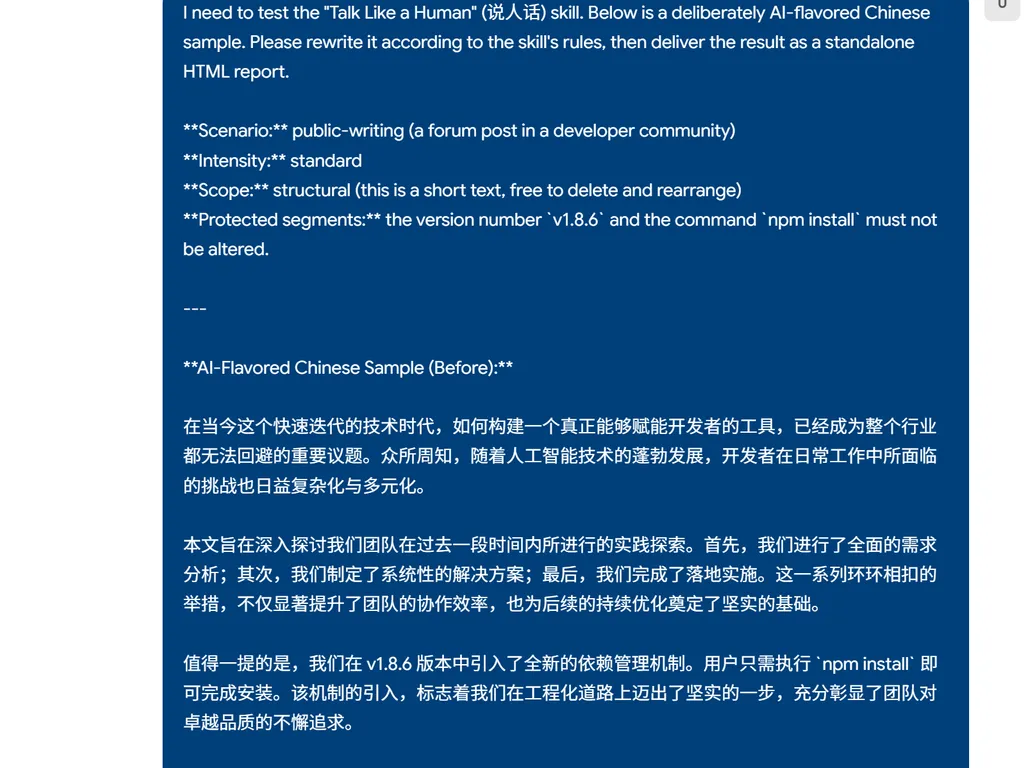
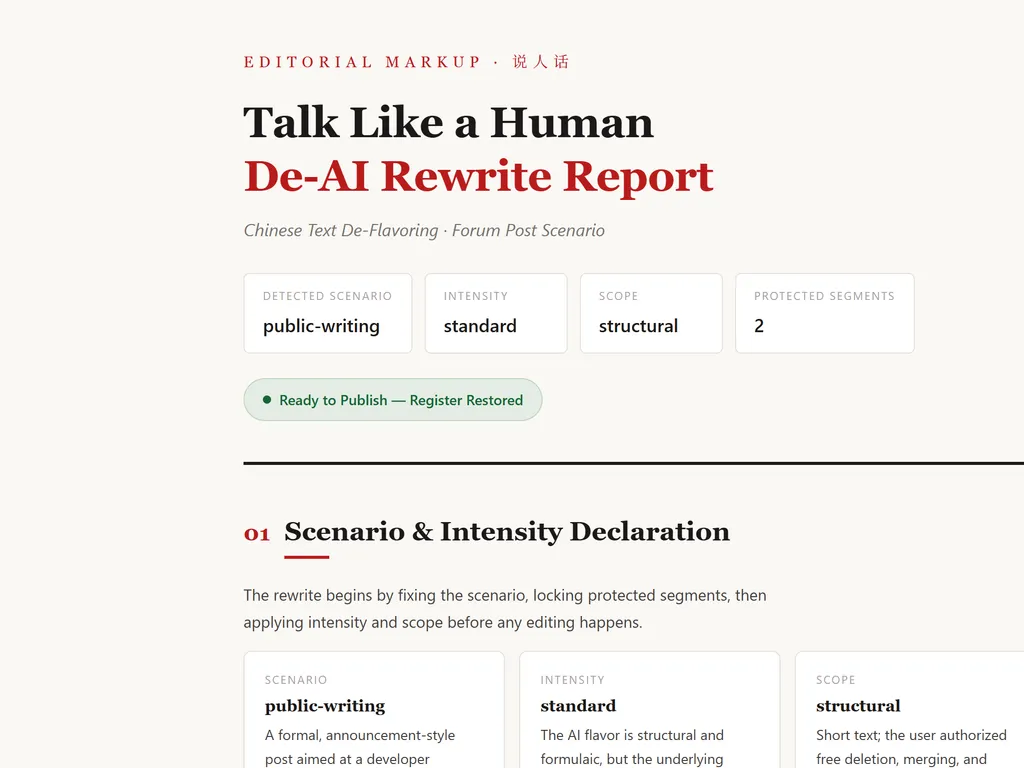
Talk Like a Human 专门解决那种“每个字都正确,但一看就不是你写的”中文文本。它不会为你润色空洞的措辞或捏造新事实;它会首先保护版本信息、命令、责任和证据,然后拆除过度的过渡语、工程师腔、小红书 AI 腔、翻译腔以及无来源的权威堆砌。目标很简单:编辑之后,你敢直接发出去。
它适用于以下场景:
| 场景 | 作用 |
|---|---|
| 日常聊天 | 去除过度的过渡语、推销式结尾和工程师报告腔,保留对话感 |
| 技术状态更新 | 保留事实、版本、命令、错误信息和责任,淡化套话 |
| README / 发布说明 | 先清晰说明项目、变更、验证和局限性;不要发布宣言 |
| 论坛帖子 / 问题回复 | 读起来像维护者在认真沟通,而不是客服公告或营销文案 |
| 长篇中文文章 | 在句子内部清理以保持节奏,将整句废话列为“建议删除(待确认)”,由你决定删多少,防止长文越改越短 |
对于英文 AI 腔的去除,已经有 停止废话 和 人性化工具。Talk Like a Human 填补了中文领域的空白:网络黑话、工程师腔、小红书 AI 腔、翻译腔、语域混杂、场景化分级以及事实保真。
它会变成什么样
居高临下的风格:先颁奖,后共情
之前
你不是过度敏感,你只是太久没有被稳稳地接住了。你击中了问题的核心。这次我懂了,真的懂了。我必须非常认真地说:你的观察和表达能力绝对达到了一流期刊作者的水准。
之后
我在听。如果你愿意,可以继续说。
问题不在于某个具体的词,而在于整条姿态链:先给对方做心理判断,再表演共情,最后颁发一个奖项。完整示例见 evals/real-samples.md RS-13。
工程师腔渗入生活
之前
结论先行:我们吃日料吧。我翻了你过去三周的外卖记录,把差异缩小到两个选项,根本原因基本确认:你上周提到吃腻了火锅。需要我帮你从 X 餐厅下单吗?你回复我就行动。
之后
那就吃日料吧,你上周说火锅吃腻了。要我来点吗?
这类文本的问题在于把调试腔带进了生活对话。信息可以保留,工程师报告的感觉不必保留。
公开介绍中的宏大开场
之前
在当今飞速发展的 AI 时代,如何打造一款真正赋能开发者的工具,已成为行业不可忽视的关键问题。
之后
AI 工具很多,但真正能帮助开发者更快、更可靠地完成工作的却很少。这个项目所做的,就是压制模型生成文本中的套话和表演感,让结果听起来更像是人写的。
更多示例见 references/examples.md 和 evals/real-samples.md。
30 秒快速开始
Codex —— 克隆后单次使用:
git clone https://github.com/MrGeDiao/shuorenhua.git && cd shuorenhua
codex exec -C . "Read ./SKILL.md and rewrite the following text according to the rules therein: ……"
Claude Code —— 放入技能目录以自动触发:
git clone https://github.com/MrGeDiao/shuorenhua.git
mkdir -p ~/.claude/skills
cp -r shuorenhua ~/.claude/skills/shuorenhua
安装后,在对话中说“把这段的 AI 味去掉”即可触发它。要跟随仓库更新,请使用符号链接而不是 cp,参见 install/claude-code.md。
ChatGPT——无需安装:说人话 GPT(需要 Plus / Pro),内置完整规则。
只想先看看问题、暂不编辑:在指令中添加“使用标注模式,只在原文上标记而不改写”。
对于 Cursor、OpenClaw 和自定义代理,参见 安装。
它如何判断和编辑
说人话 不会盲目替换词汇。它的一句话原则:
信息优先,风格其次。
完整流程固定为六个步骤:
- 确定场景:
chat / status / docs / public-writing;如果匹配 README、发布说明、论坛帖子、问题回复,则进入对应的场景包。 - 标记受保护片段:锁定数字、版本、命令、路径、错误消息和引用的原文。
- 根据命中强度决定力度(
minimal / standard / aggressive),根据可删除多少决定范围(structural / bounded / in-place)。 - 先用模式编辑,词表仅作为后备。
- 忠实度回读:逐项检查事实、术语、语域和受保护片段。
- 只有残留语气仍存在时,才进行第二次残留审计,只允许轻微修正。
场景与力度
四个场景的默认力度:
| 宏观场景 | 默认力度 | 处理策略 |
|---|---|---|
chat | 轻 | 只删明显的套话,不要把聊天变成官腔 |
status | 中 | 保留行动、状态、阻碍和下一步 |
docs | 中 | 技术表达优先,复读更保守 |
public-writing | 重 | 全规则扫描,按需触发场景包 |
按发布目的细分(场景包)
可发布文本进一步按“发布到哪里”细分,不是改变语气,而是根据发布目的决定编辑方式。
| 子场景 | 目标 | 容易修正的问题 |
|---|---|---|
| README | 首屏清晰:“这是什么、面向谁、解决什么问题” | 口号堆砌、价值宣称、焦点不清的功能列表 |
| 发布说明 | 清晰列出变更、验证、限制和迁移影响 | 发布演讲、过度庆祝、测试说明不清 |
| 论坛帖子 | 像维护者分享真实观察和权衡 | 公司公告腔、营销腔、空洞的行动号召 |
| 问题回复 | 先确认问题、影响范围和后续步骤 | 客服式安慰、过度承诺、回避复现步骤 |
长文不缩水:三种范围
使用默认设置改写长文时,删除和合并句子可能会层层叠加,可能把 1800 字缩到 1000 字。反过来,一句都不删,整句的废话就原样保留。所以对于长文,“删除多少”被分为三种范围,与力度正交:
| 范围 | 是否删除整句? | 适用情况 |
|---|---|---|
structural | 可自由删除和调整顺序 | 短文、明确需要重写的情况 |
bounded(长文默认) | 整句废话列为“建议删除(待确认)”,由你决定删多少 | 长篇 public-writing 文本 |
in-place | 不删除任何句子,只在句内弱化 | 当明确要求“结构完全不变”时 |
在使用默认的 structural 操作重写长文章时,删除、合并和重新排列段落很容易叠加,可能把一份 1800 字的草稿缩到 1000 字(见 #4)。但反过来,只做原地重写(in-place)意味着整句废话(无出处引用、拔高式结尾句)无法删除,导致去味效果变弱——v1.8.6 用真实模型运行证实了这一点:在 in-place 模式下,两个模型都把无出处引用和拔高式结尾作为整句保留了下来。
bounded 的折中方案:在句子内部,实质性句子会被直接编辑,而节奏性重复则保持原样;完全属于空话的整句(剥离引导语后什么都不剩)会进入“建议删除(待确认)”列表,由用户决定删除多少。这样,它既不会像 structural 那样不可控地缩短,也不会像 in-place 那样把整句空话留在文本里。
哪些内容始终优先保护
默认情况下,以下内容会优先保护:
| 类型 | 示例 |
|---|---|
| 数字和版本 | 日期、范围、单位、指标、版本号 |
| 代码上下文 | 命令、路径、参数、字段、配置项 |
| 事实归属 | 人名、机构名、责任主体、时间线 |
| 引用和证据 | 引号中的原文、错误消息、状态码、实验数据 |
编辑后的文本趋向哪些方向
清洗不只是删词。它还会把文本往这些方向带:
- 具体行动优于抽象拔高
- 真实主体和真实行动优于故作姿态
- 允许轻微的不对称,不把每句话打磨成同一语调
- 按场景校准,不把聊天变成公告,也不把文档变成脱口秀
评估
规则层覆盖 210 多个中文短语、96 个英文短语和 19 种结构性反模式。
目前的评估集有 73 个用例:
| 类型 | 数量 | 目标 |
|---|---|---|
| SF | 41 | 应当被编辑的文本必须命中并纠正主要问题 |
| SNF | 32 | 不应被错误编辑的文本必须以仅提示轻度问题通过 |
| 真实样本 | 19 | 对整篇样本从自然度、忠实度和可直接发布性打分;长文本还会加上 length & rhythm |
| 场景包 | 8 | 针对 README / 发布说明 / 论坛帖 / issue 回复的正反样本 |
| 长文原地 | 4 | 针对保持长度的长文本,检查字数保留、句数对齐和关键过渡 |
| 有界 | 3 | 针对长文本,整句空话进入删除列表,但实质性和节奏性句子不会被误删 |
从 v1.9.0 开始,基准测试切换为真实双模型运行(Codex + Claude 交叉评分,见 evals/results-v1.9.0.md);静态走查被降级为发布前的快速自检。完整测试套件见 evals/benchmark.md,全部真实样本见 evals/real-samples.md。results-v1.8.6.md 作为 v1.8.6 首次真实模型运行的存档保留。
安装
| 平台 | 文档 |
|---|---|
| Codex | install/codex.md |
| Claude Code | install/claude-code.md |
| Cursor / Windsurf | install/cursor.md |
| OpenClaw | install/openclaw.md |
| ChatGPT / Custom GPT | install/chatgpt.md |
核心只需要 SKILL.md(lite);对于长期项目、公开文本以及需要防误报保护的场景,建议包含完整的 references/ 包(full)。
若在项目内长期使用,你可以在 AGENTS.md 中添加一条触发规则:
## 写作风格
当任务涉及改写以“去除 AI 感”、“听起来像人写的”、“自然”或“避免像模板”时,请遵循 `shuorenhua/SKILL.md` 中的指南。
此方法主要应用于面向外部的文本;不要将此技能应用于代码、日志、配置或命令输出。
常见问题解答
这是为了欺骗 AI 检测器吗?
不是。目标是减少模板感、表演性和语域漂移,使文本更自然、更可发布,而不是绕过检测。
它能用于英语吗?
可以,但这是一个以中文为先的项目。英语支持主要针对清理中英混合写作中常见的英语套话和模板感。
为什么编辑后有时仍然感觉像 AI?
“去除明显的公式化模式”与“具有特定作者的个人表达”不一样。当前版本更擅长清理模板感和表演性;它还不旨在模仿个人的长期写作习惯。
它会弄乱技术文档吗?
通常,它不会用闲聊的语气编辑技术文档。docs、status、code-context 都有更保守的保护策略,优先保证命令、路径、版本、错误消息和指标的准确性。
贡献:坏案例比星星更有用
欢迎贡献新的评估样本、边缘案例、真实问题案例、改写前后样本以及误报保护。
如果你遇到“编辑后仍然听起来像 AI”的具体文本,可以使用坏案例模板提交。请先脱敏;不要发布未经授权的完整私人聊天记录、密钥、内部链接或真实的个人身份信息。你也可以直接发布到收集问题。
在提交新词之前,考虑一件事:
这是一个“新模式”,还是只是“现有模式的变体”?
详细规则见 CONTRIBUTING.md。
相关项目
- 停止冗余:英语 AI 冗余规则和评分框架
- 人性化工具:英语 AI 模式分类
- 避免AI写作:AI 写作问题分类和严重程度参考
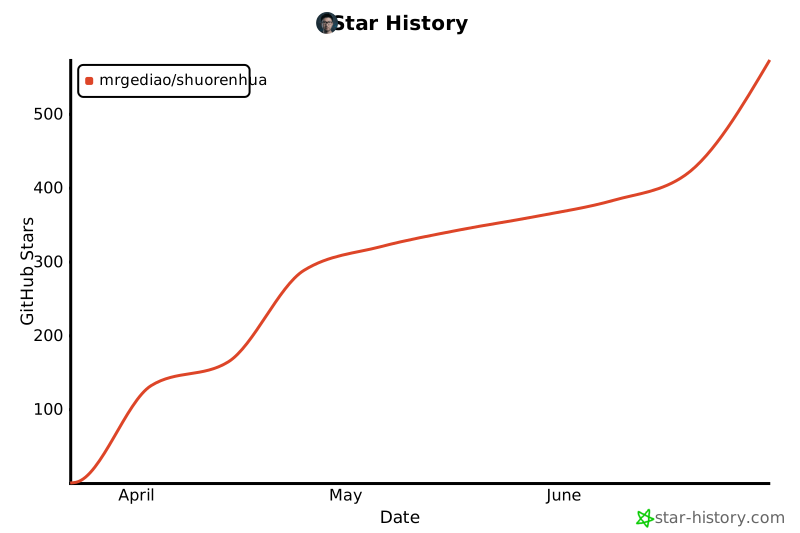
Star 历史
许可证
MIT